AutoCompress:把硬件与负载约束纳入模型剪枝
这项研究把延迟、吞吐量和内存预算纳入架构搜索,并在目标推理引擎中测量成本。其单卡大模型案例同时报告了部署条件与压缩后的质量损失。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-05
先指定硬件与请求负载
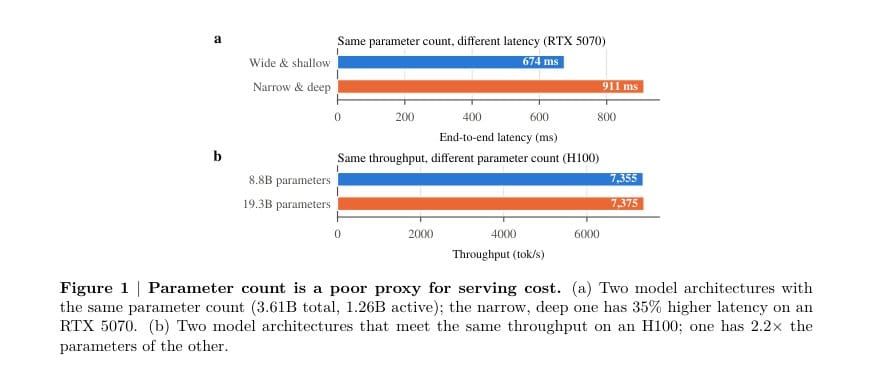
AutoCompress 将部署目标作为剪枝输入,需指定硬件、推理服务配置、精度和工作负载,包括批大小、已缓存前缀长度及输入输出长度。资源约束可以是内存上限、延迟上限或吞吐量要求,也可以组合使用,参数预算并非唯一目标。
各层可以保留不同容量
搜索同时覆盖全局与逐层维度,包括隐藏维度、Mamba头数、各层专家数量和前馈网络宽度,可选项取决于父模型、部署目标及推理引擎支持。混合专家层的路由宽度为零、共享宽度为正时保留稠密前馈层,两者均为零时才移除该层。
按执行轨迹建立成本模型
作者运行包含多种层配置的模型,采集目标推理引擎的执行轨迹,再按层边界拆分预填充和每一步解码时间,建立延迟表。同一次测量还记录总内存;实测值与内存公式之间的残差用于设置容差,使估计对应具体服务环境。
搜索后再用蒸馏恢复质量
流程先建立成本模型,再按重要性排序父模型组件、重排权重,初始化共享候选架构权重的超网络。随后联合训练架构路由器与超网络,由冻结的父模型提供蒸馏监督,并加入资源惩罚。选定架构后,还要提取权重并再次蒸馏,生成独立模型。
单张B200案例的条件与质量代价
作者报告,Nemotron 3.5 Super从120B压至74B参数后,在单张B200上以BF16、128K上下文、批大小16服务,内存占用不超过178 GB;平均基准得分下降2.85分。该均值对九项指标不加权汇总,其中GDPval-AA v2为指数,其余八项为百分比,因此不能将这一降幅直接称为准确率下降。
原始标题:AutoCompress: Automated Hardware-Guided Model Compression
来源:arxiv.org

