FastFrames:用轻量解码与缓存修复降低视频生成延迟
论文针对像素解码与缓存更新优化推理路径,在标准文生视频设置下报告36毫秒稳态延迟;交互应用仍受采样步数和生成块大小约束。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-17
从输入到可见响应计时
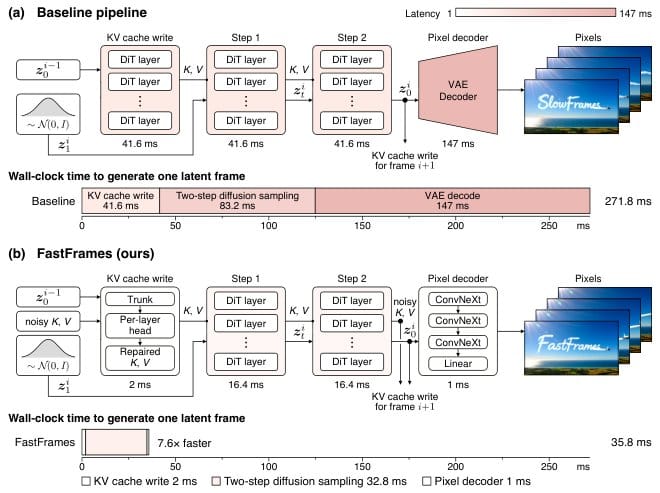
FastFrames将目标设为低于50毫秒的端到端延迟:从新控制信号到达,计时到首张体现其效果的RGB帧呈现。作者要求覆盖KV缓存更新、扩散采样和像素渲染的完整路径,因为批量生成的帧率无法直接说明用户需要等待多久。
在低分辨率网格完成解码
像素解码器用因果三维深度卷积和通道混合网络处理特征,所有卷积都留在Transformer的低分辨率令牌网格上,最后由线性层输出RGB图像块。这条路径替代了原VAE解码器逐级放大特征并执行密集卷积的过程。
用修复网络更新键值缓存
缓存修复网络读取最后一次去噪留下的带噪键值,以及模型预测的干净潜变量,再将校正结果写回同一缓存位置。后续生成由此读取修复后的上下文,省去基线用于更新缓存的额外一次完整扩散Transformer前向计算。
36毫秒对应文生视频稳态测量
论文明确将自身测量口径称为稳态延迟,并与视频流启动时的首帧时间区分。因此,下述数字描述持续生成过程中的响应等待,不能用来表示从启动视频流到看到第一张画面的耗时。
在标准文生视频设置中,模型把当前生成帧作为生成下一帧的输入。作者报告,1.3B版本在单张B200上、以832×480分辨率运行时,端到端逐帧延迟为36毫秒;该结果对应上述任务与硬件条件。
交互适配仍受生成步数约束
交互适配中的LingBot每轮采样四步、生成四个潜帧,RealWonder则为三步、三个潜帧。作者说明,这两种设置即使采用1.3B模型,也需要八张GPU才能达到交互延迟。减少步数与每轮潜帧数,同时保持画质和控制遵循,仍是后续工作。
原始标题:FastFrames: Video Generation at Interactive Latency
来源:arxiv.org


