Gamer:以统一键鼠动作训练长时程游戏智能体
论文介绍了从跨游戏轨迹预训练、指令标注到在线强化学习的训练流程,并说明实时推理中缓存复用的数值一致性边界。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-13
以屏幕和键鼠统一交互
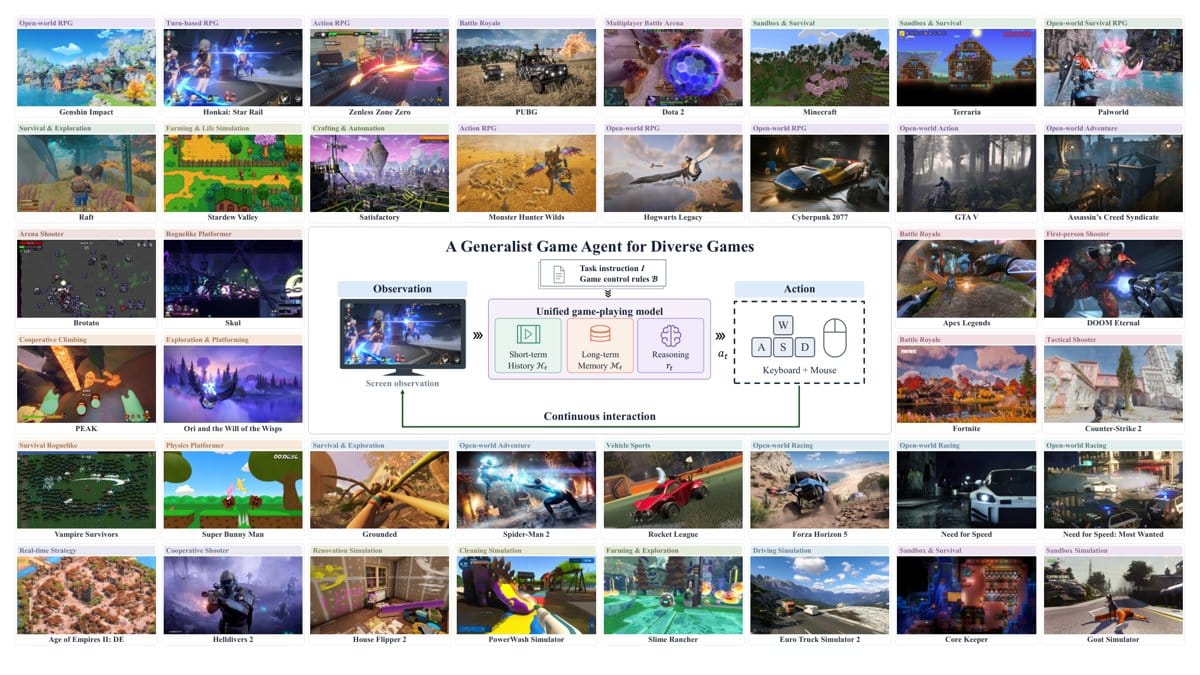
Gamer 是论文提出的通用游戏智能体框架,从原始屏幕像素读取环境,通过原生键盘和鼠标操作执行动作,不依赖游戏专用接口或定制动作空间。作者先将不同来源的控制格式映射为统一键鼠表示,再利用跨游戏轨迹继续预训练,学习可迁移的控制方式。
降低按键频率与重复动作的偏差
预训练采用随机按键重映射,减少模型对特定按键身份的依赖;同时让连续重复动作的损失权重逐步衰减。新动作获得完整权重,后续重复动作的贡献降低。按作者的设计,这保留了动作持续时间的信息,并把监督重点移向停止、转向和交互等行为变化。
为轨迹补充指令与记忆
作者用大模型辅助标注,为原始轨迹补充任务指令、关键决策处的推理和记忆摘要,同时保留原有观察与动作序列。论文称由此构建了超过千小时的指令数据,覆盖局部操作、中间子目标与完整任务;后续通过稀疏思考指令微调和在线强化学习,处理长期目标、执行误差与稀疏奖励。
实时推理的一致性边界
训练与在线交互保持动作序列化、词元边界和环境时序一致,但这不代表两者计算过程完全相同。部署侧的 Streaming-vLLM 使用缓存复用和记忆压缩;作者明确说明,位置相位调整不能重建完整上下文重新编码的输出,因此一致性限于接口与交互语义,不保证输出数值逐位相同。
原始标题:Gamer: A Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent
来源:arxiv.org


