HDM:用共享骨干判断何时启动显式推理
论文让同一冻结骨干承担直接决策与自回归推理,由轻量模块选择模式,并披露任务回报训练及候选编码的局限。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-12
共享骨干承担快慢两种模式
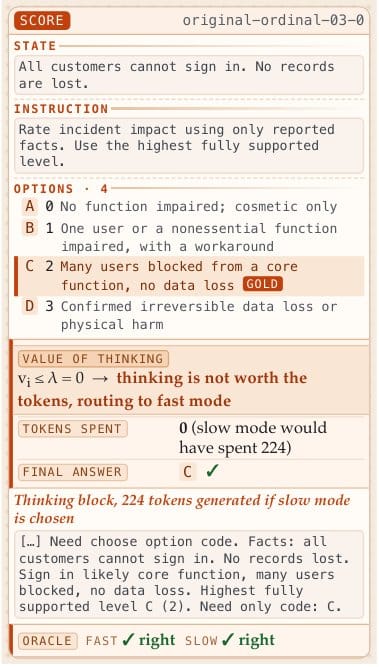
作者提出混合决策模型 HDM,由同一个冻结骨干承担两种模式:快模式在一次前向计算中直接作出决策,不生成词元;慢模式进行自回归推理。轻量自路由模块估计慢模式可能增加的收益,只有估计值超过请求设定的价格 λ 时才启用慢模式。“零词元”仍包含前向计算。
推理收益与答案置信度分开判断
判断收益不等于看快答案有多自信。论文指出,慢推理可能把原本正确的答案改错,也可能在两种模式都答对时没有增加收益。因此,路由需要联合估计快慢模式的结果,而非仅凭快答案的置信度决定是否推理。
CDPO 的任务回报与归因缺口
CDPO 利用整段任务回报训练路由模块。作者承认,它优化的是替代目标:逐决策重要性比率替代整条轨迹的比率,会引入偏差;同一任务内各步共用回报,无法区分单步贡献;训练还会重新抽取价格,却不重新采集轨迹。这些限制意味着训练信号不能直接解释每一步选择是否合理。
候选编码读出存在位置偏好
论文报告的实验全部使用候选编码读出:把候选项映射为单词元字母,在指定位置读取这些字母的概率分布。作者指出,编码词元自带的先验会附着到对应候选项上;在 MMLU-Pro 中,受偏好的位置与答案分布并不吻合,两个骨干偏好的位置也不同。
原始标题:The Value of Thinking: Learning When to Reason in Hybrid Decision Models
来源:arxiv.org


