HINT-WAM:用示范未来视频指导机器人动作后训练
教师在训练时读取示范的未来画面,学生沿自身动作去噪轨迹接受监督。方法不采集新环境状态,其评测范围也需与未见任务泛化区分。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-18
三阶段训练与未来视频教师
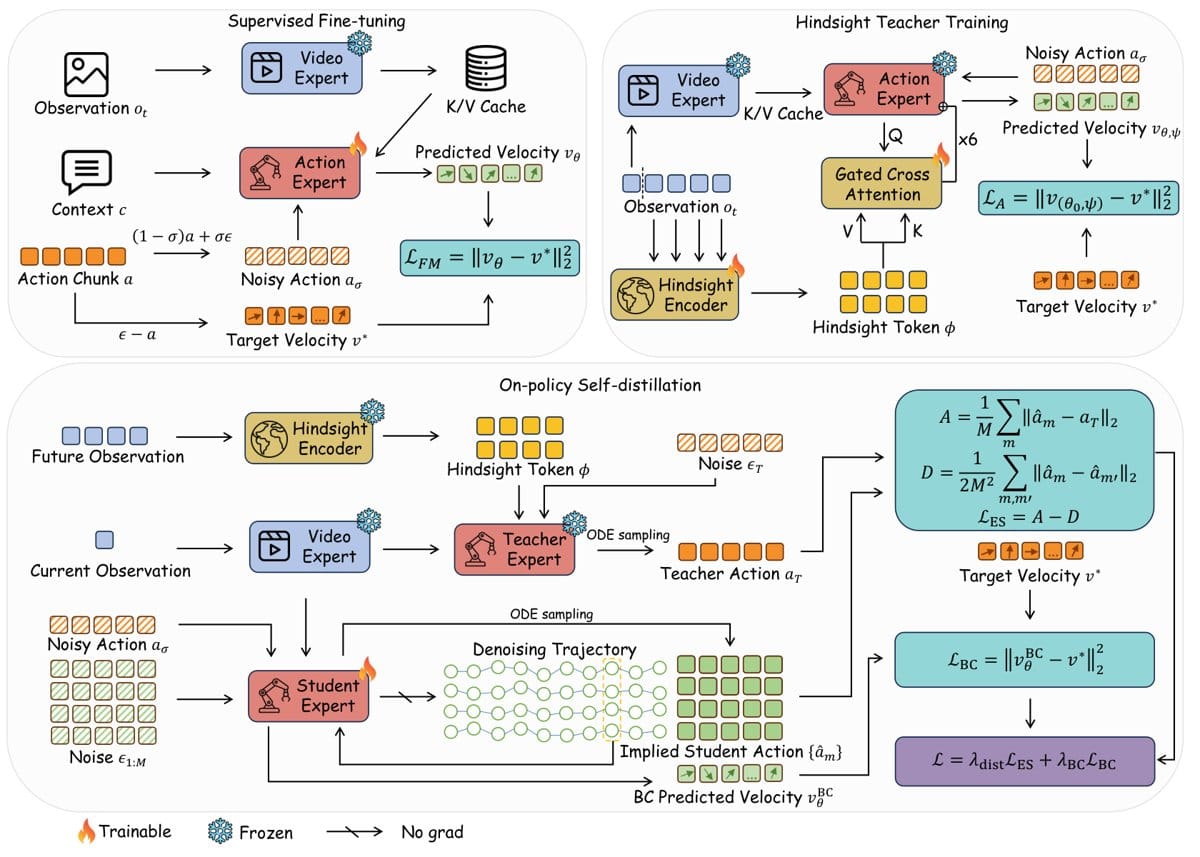
HINT-WAM用示范的未来视频构建教师,指导机器人动作模型的后训练。流程先对动作专家进行监督微调,再冻结微调模型,只训练压缩未来画面的编码器和门控交叉注意力适配器;最后让学生生成自己的去噪轨迹,接受教师监督。视频专家保持冻结,部署时只使用学生。
能量评分匹配动作分布
教师读取未来画面,学生没有这项信息,同一学生输入可能对应多种合理动作。作者认为,直接回归教师的速度场会把这些动作模式平均化。因此,方法采用能量评分,从学生自身生成的动作样本与一个教师样本出发匹配动作分布,目标是保留不同的动作模式。
同策略监督的范围
论文中的“同策略”限定在动作采样层面:学生在自身去噪过程中经过的状态上接受监督,环境观测仍取自示范。因此,这套训练不需要环境奖励或模拟器,但跨控制步骤累积的误差仍在其处理范围之外;作者将它视为可与交互式数据收集或强化学习配合的方法。
LIBERO评测检验初始配置泛化
LIBERO-90实验的训练与评测使用相同的90项任务,但采用不同回合。作者从示范中留出一成回合,仅用于离线损失评估;闭环评测则对每项任务运行50个新回合,使用基准提供的固定初始状态。由此得到的结果应解读为对训练任务中留出初始配置的泛化,而非对未见任务的泛化。
原始标题:HINT-WAM: Hindsight-Informed Training for World Action Models
来源:arxiv.org


