Invoker-Render:用粗细结构代理控制视频生成
论文以统一输入接口支持离线创作与四步流式生成,分阶段引入自身生成历史;结构监督和粗细代理配对均有适用条件。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-17
同一权重接受不同结构精度
论文提出的Invoker-Render接收结构代理、外观参考和语言,覆盖语义布局、着色几何等表示。作者希望同一组权重既能遵循精细几何约束,也能在粗略代理省去局部细节时补出合理动作,让使用者按交互需要选择输入精度。
完整片段创作与逐块生成
离线创作时,用户编辑完整代理序列,调整镜头路径、运动轨迹和事件时序,双向模型可以查看整个片段。流式生成则逐块接收代理和局部文本,利用保留的视觉历史,以四步生成当前块,适应未来动作尚未确定的交互过程。
分阶段适应自身生成历史
为处理生成步数压缩与历史误差累积,作者设计了ProForcing:先训练因果预测器,再利用训练视频衍生的历史,将其蒸馏为四步渲染器,之后转向连续使用自身生成内容的训练,让模型逐步适应推理时遇到的历史输入。
结构监督与粗细配对的边界
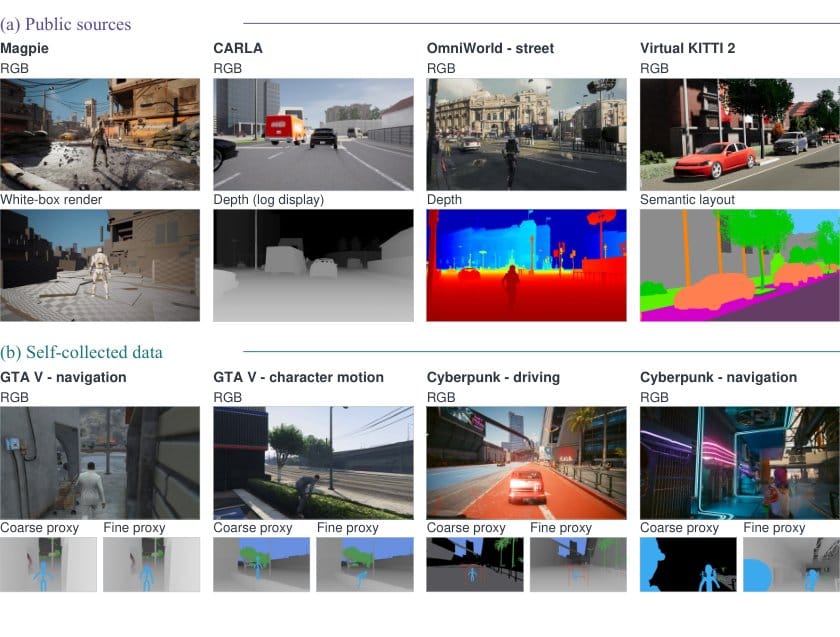
公开数据先经过几何与时间有效性检查;缺乏可靠结构对齐的片段,仅用于外观参考与文本监督。各来源可以贡献自身已有的结构模态,并不要求每个来源都具备合成的粗细代理配对,因此不能将全部训练片段视为完整结构监督样本。
同一事件的粗细代理配对也有明确范围:只有已构建两种变体的数据,才共享相机参数、时间戳、实体身份和目标视频。这样的配对用于监督不同约束强度,不能推广为所有数据都具备的属性。
30分钟赛车结果的证据范围
作者报告,模型在30分钟赛车连续生成中保持了场景与主体外观稳定。所给节选没有展开这一结果的评测指标与判定细节;这一特定场景、有限时长的报告,也不足以把论文标题中的“无限”视为已经验证的能力。
原始标题:Code World Model 2.0: Towards Infinite Controllable Video Generation
来源:arxiv.org


