JVT:直接在像素空间生成视频,并联合输出视差
JVT以简化的DiT式Transformer处理原始视频,研究分块嵌入与条件注入,并展示由RGB和视差生成彩色点云的方法。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-13
从带噪像素预测干净视频
论文提出JVT,用DiT式Transformer直接建模视频像素,不依赖预训练自编码器,也不使用辅助细节模块、级联生成阶段或U-Net式跳跃连接。其训练沿用JiT的思路,从带噪像素预测干净视频,并采用整流流目标。
默认采用先空间后时间的嵌入
视频分块嵌入负责初始降采样,也控制送入Transformer的序列长度。作者考察不同嵌入方式及通道瓶颈宽度,最终默认选择先处理空间、再聚合时间的方案,瓶颈宽度为32。这是论文在生成质量与计算效率之间作出的配置选择。
寄存器引导在采样时启用
寄存器引导通过比较同一模型保留和移除寄存器时的预测,放大寄存器的贡献,是论文研究的采样选项。作者没有沿用训练时随机丢弃寄存器的做法,而是训练期间始终保留,仅在采样计算无寄存器分支时移除。
用RGB与视差构造彩色点云
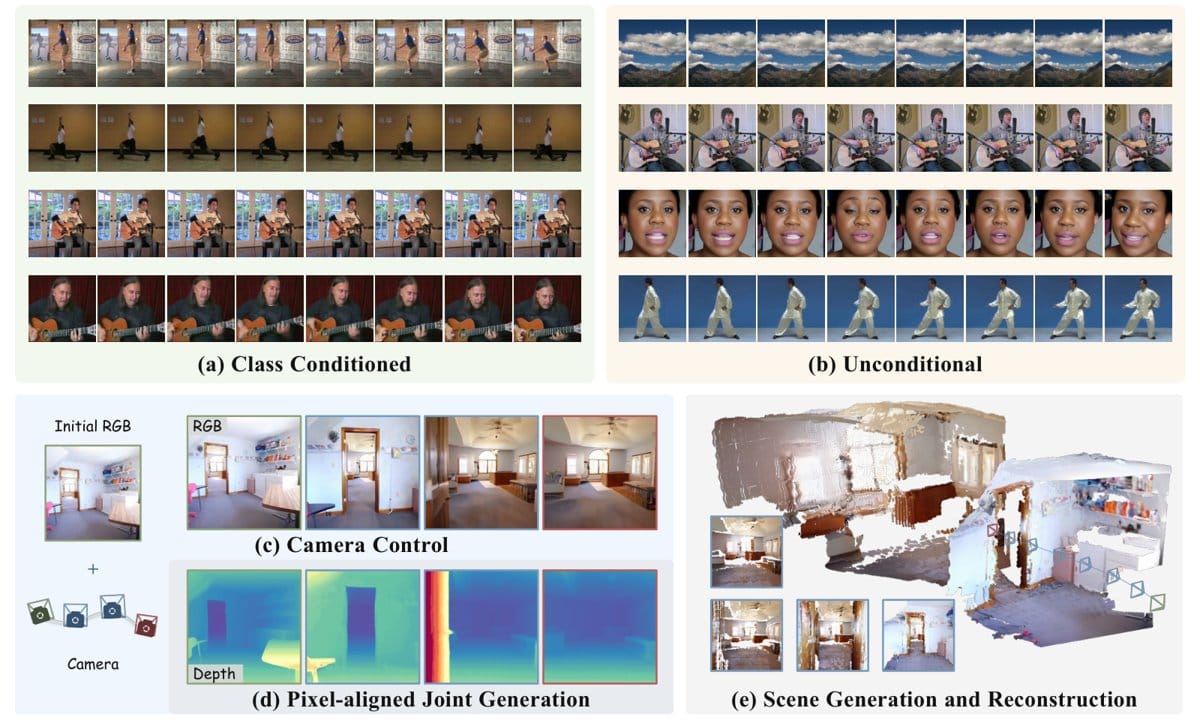
论文将联合生成具体用于相机条件下的RGB与视差视频。推理时,先把预测视差转换为深度,再利用相机参数进行反投影,与生成的RGB帧组合成连续的彩色点云。该演示无需额外重建模型,但输出几何仍来自模型预测的视差。
FVD结果需要保留样本量口径
评估口径是阅读结果时的一项限制。作者主要用2048个生成视频计算弗雷歇视频距离,即FVD;部分其他方法使用10000个样本。论文明确说明样本量会显著影响分数,因此另行报告了10000样本结果,不能把两种口径的数字直接混用。
原始标题:JVT: Just Video Transformer makes pixel-space video diffusion simple
来源:arxiv.org


