LFM3:把小模型按文字、视觉和声音拆开用
Liquid AI 推出共享底座的模型家族,目标是可定制、可在设备端运行的专用能力。
本站编译 · 原文日期 2026-10-27 · Hugging Face Blog
共享底座,按输入选模型
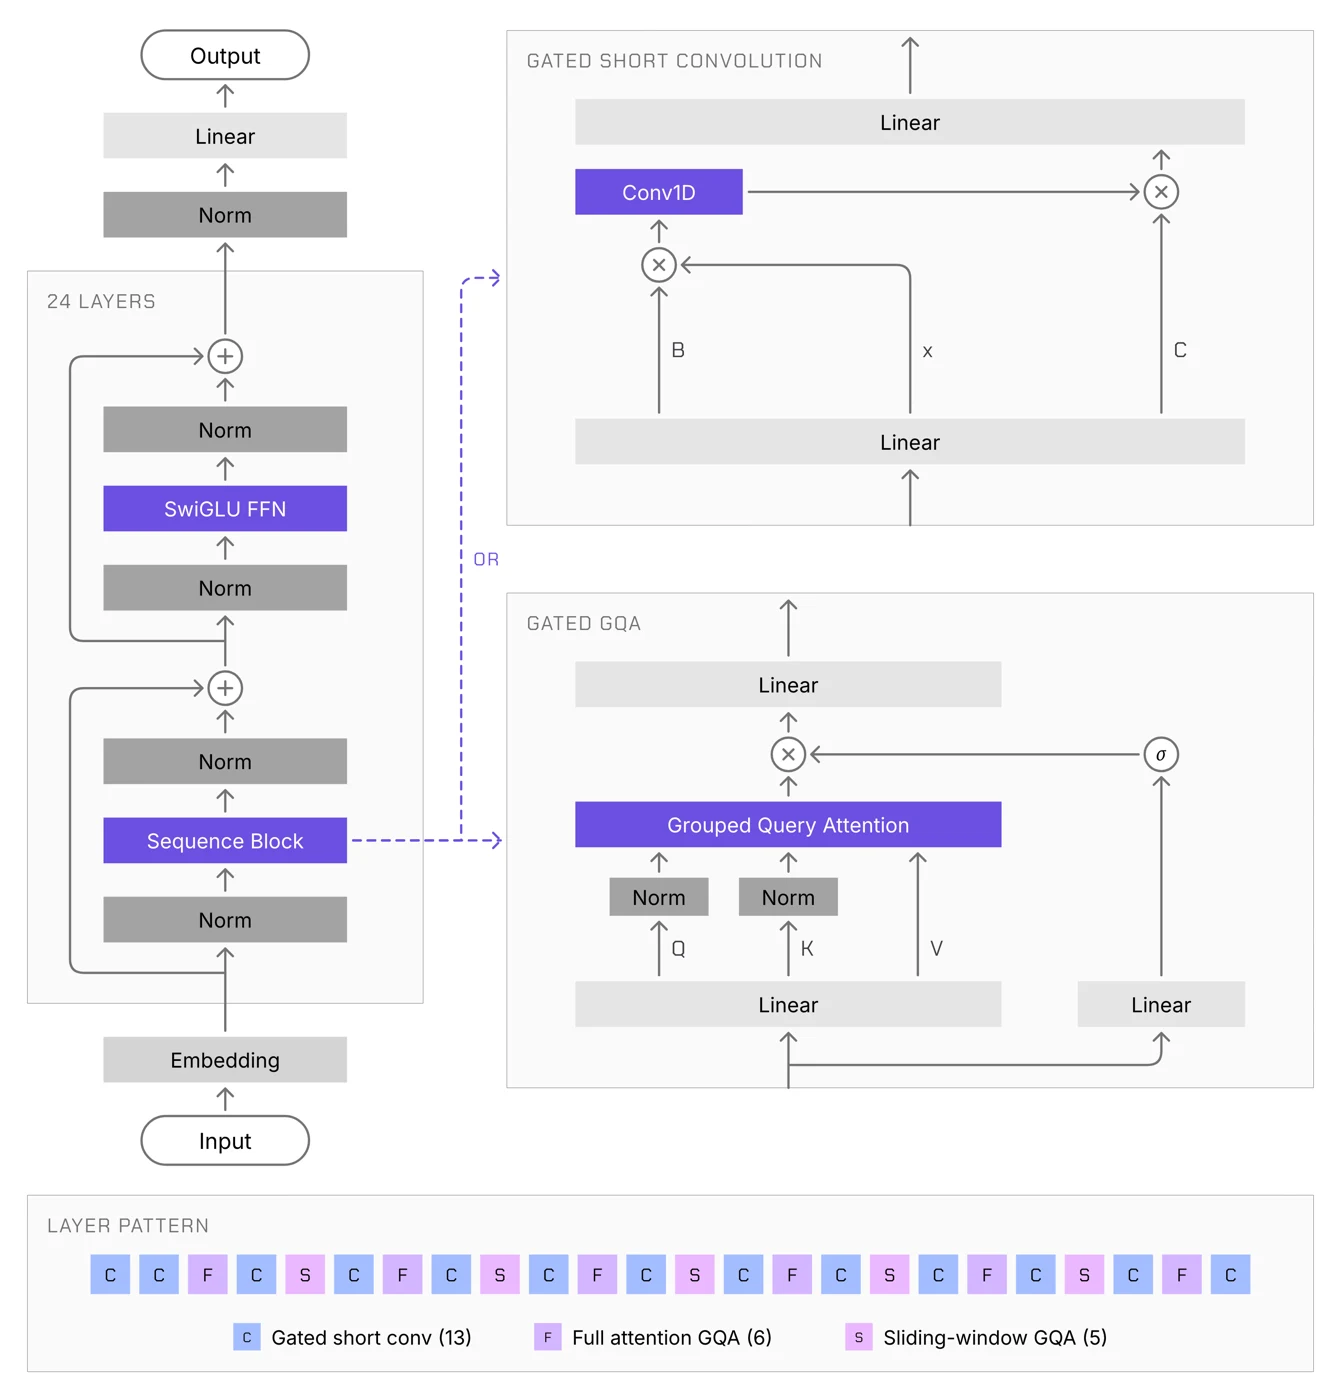
LFM3 家族覆盖文字、视觉、音频、全模态和决策任务。发布文章强调约 2B 规模的模型与共同底座,开发者可以按实际输入挑选分支,再考虑领域微调。
小模型的意义在部署环节
项目把设备端推理、量化和单卡定制作为主要使用方向。文本、视频和语音输入带来的运行开销不同,模型参数接近,并不表示它们占用相同内存或具有同样的延迟。
值得怎样试
先挑一个明确任务,例如对固定类型图片做描述,或把短音频转成结构化结果。用自己的样本测错误类型,再决定是否需要更大模型;发布方的设备测试只适用于其说明的条件。
原始标题:Build specialized multimodal models with LFM3
来源:Hugging Face Blog

