llama-modchip:用分层量化把 MoE 模型放进系统内存
项目通过混合量化与 CPU 内核补丁降低内存需求。DeepSeek-V4-Flash 默认计算每层 Top-6 选中的六个路由专家,裁剪为可选设置;自定义格式需要配套运行时。
项目实践 · github.com · 原文日期 2026-11-08
64 GB 内存的部署目标
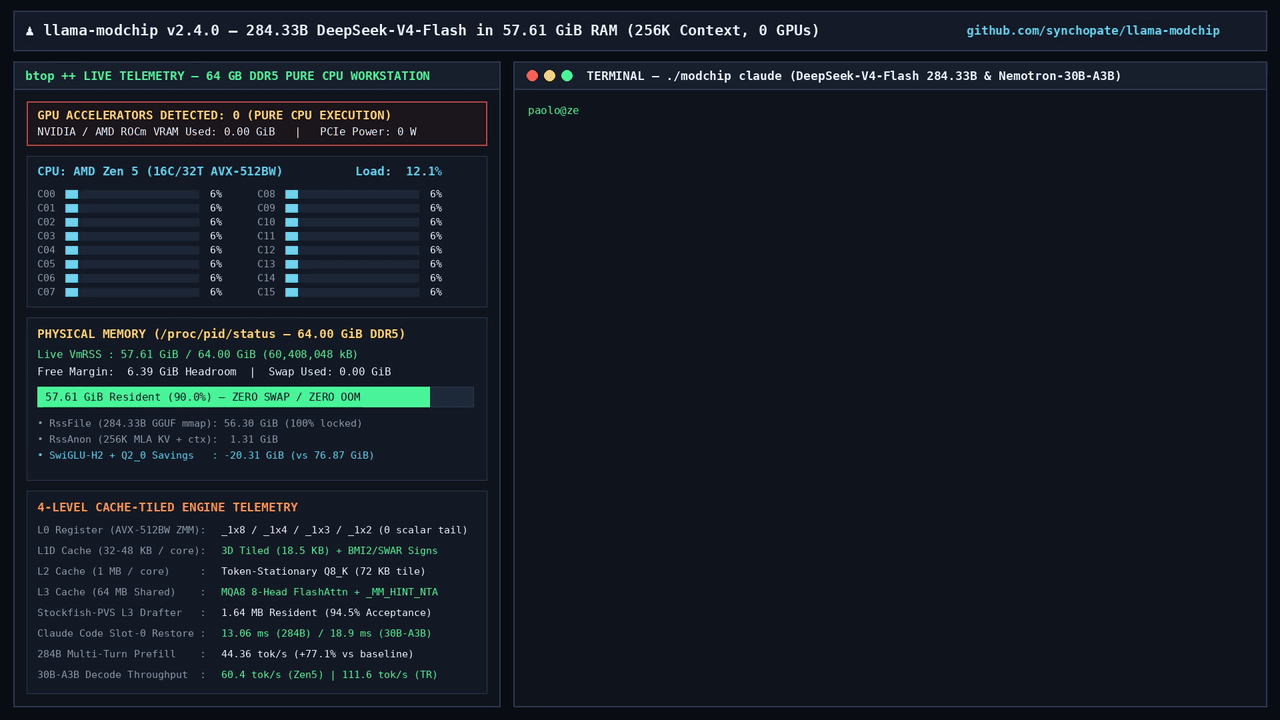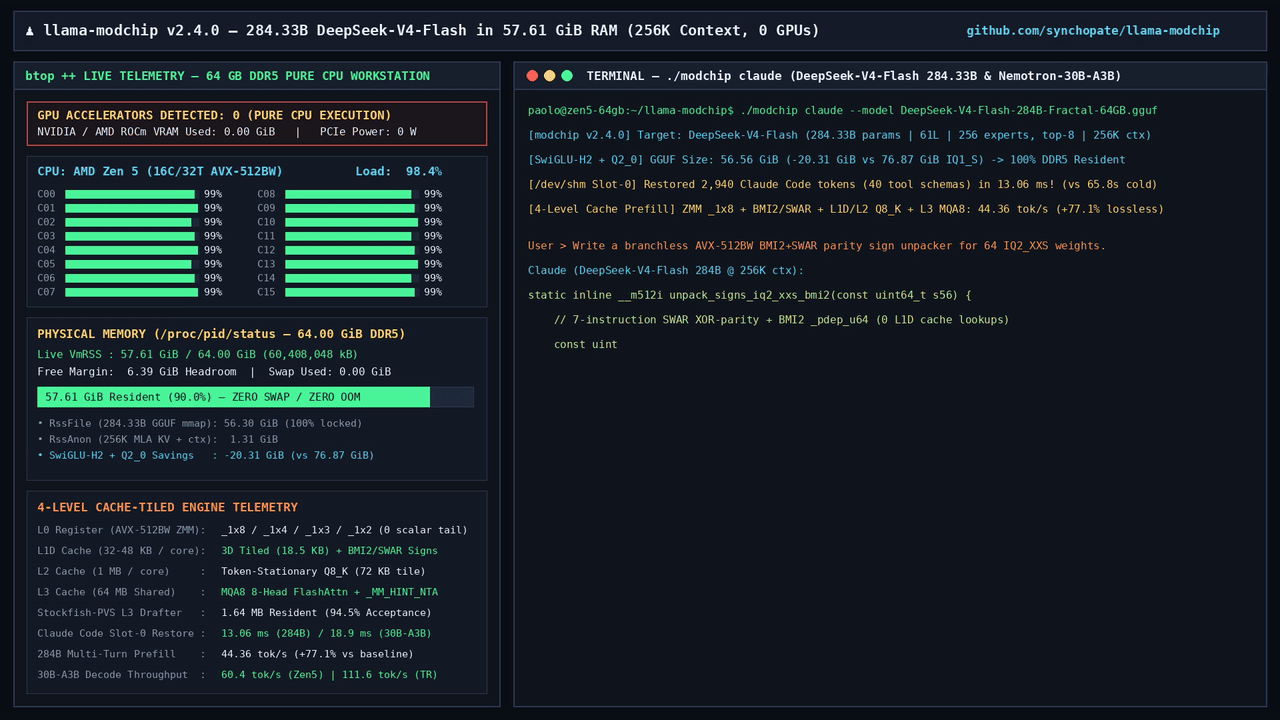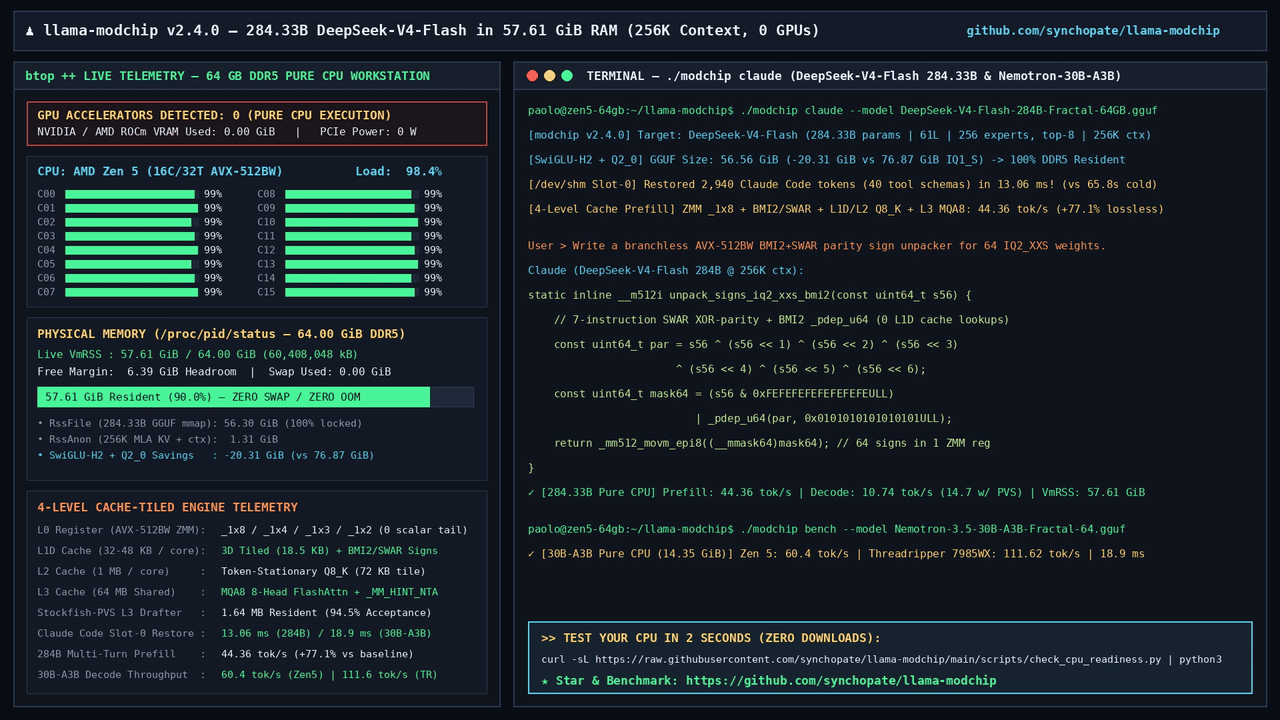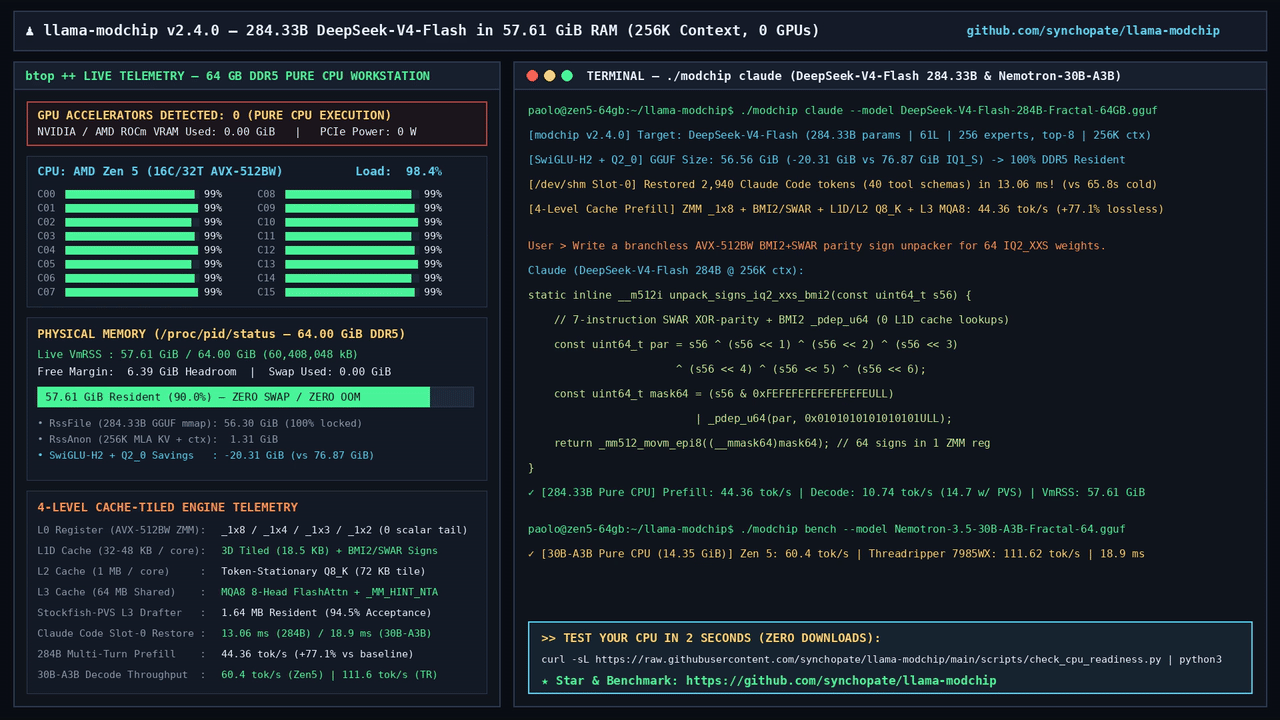
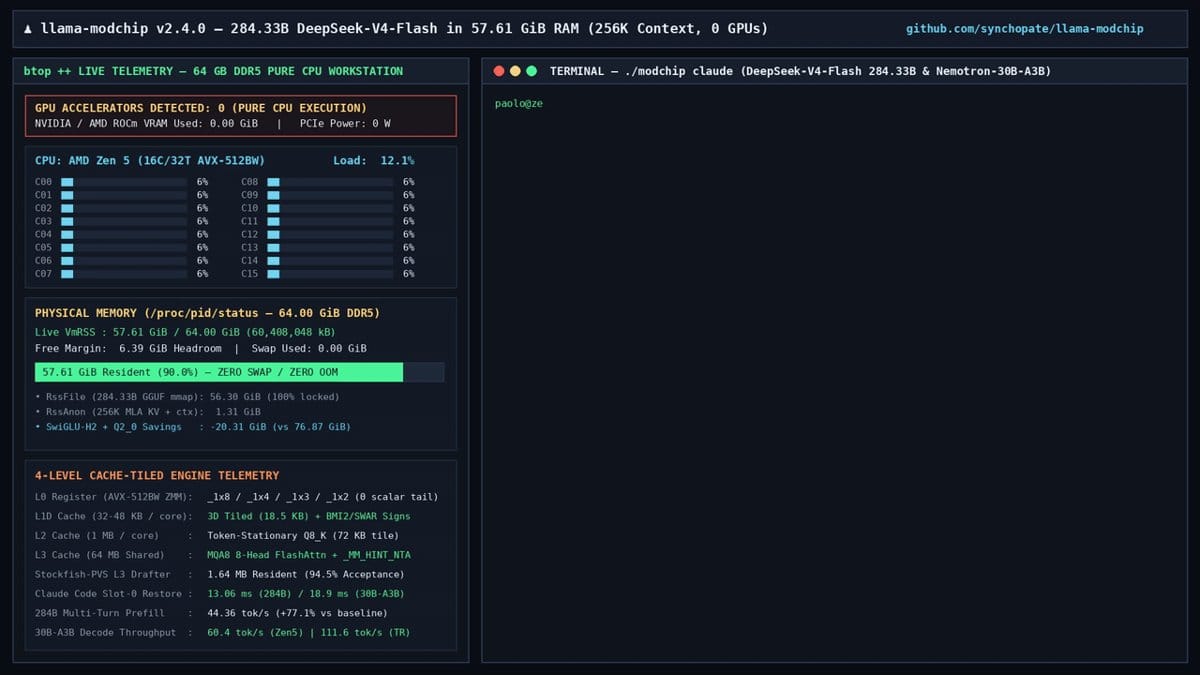
llama-modchip 的一个目标,是让大型稀疏模型完整驻留系统内存。作者称,DeepSeek-V4-Flash 检查点压缩后为 56.56 GiB,连同 256K 上下文的 KV 缓存,进程常驻内存约为 57.61–58.9 GiB,可放入可用内存约 62.5 GiB 的 64 GB Linux 系统。这些容量数据来自项目文档。
按张量角色分配量化格式
量化采用按模块分配格式的方式。以 Nemotron 30B 的 Fractal-64 版本为例,注意力、Mamba-2 状态空间模块和共享专家使用 Q4_0、Q8_0 或 F32;路由专家则混用 Q4_0 与 Fractal-64,后者采用 64 权重块及 BF16 缩放因子。文档列出的文件大小为 14.35 GiB,体积本身不能说明任务质量。
Top-6 默认计算,裁剪另行开启
DeepSeek-V4-Flash 默认每层计算 Top-6 选中的六个路由专家和一个共享专家,并非计算全部 256 个路由专家。将路由专家数降为五个或四个属于可选设置,文档称其以困惑度变化换取吞吐量。“无损”标签仅涉及同一量化检查点与未打补丁运行时的对照,不能视为相对原始权重的质量保证。
先确认配套运行时
接入时需要先确认模型格式兼容性。文档说明,Fractal-64 使用编号为 40 的自定义张量类型及专用内核,未打补丁的 llama.cpp、Ollama 和 LM Studio 会拒绝加载。项目提供 modchip 统一入口及独立预编译程序,使用这些量化文件时应配套选择支持该格式的运行时。
原始标题:llama-modchip (v2.4.0)
来源:github.com