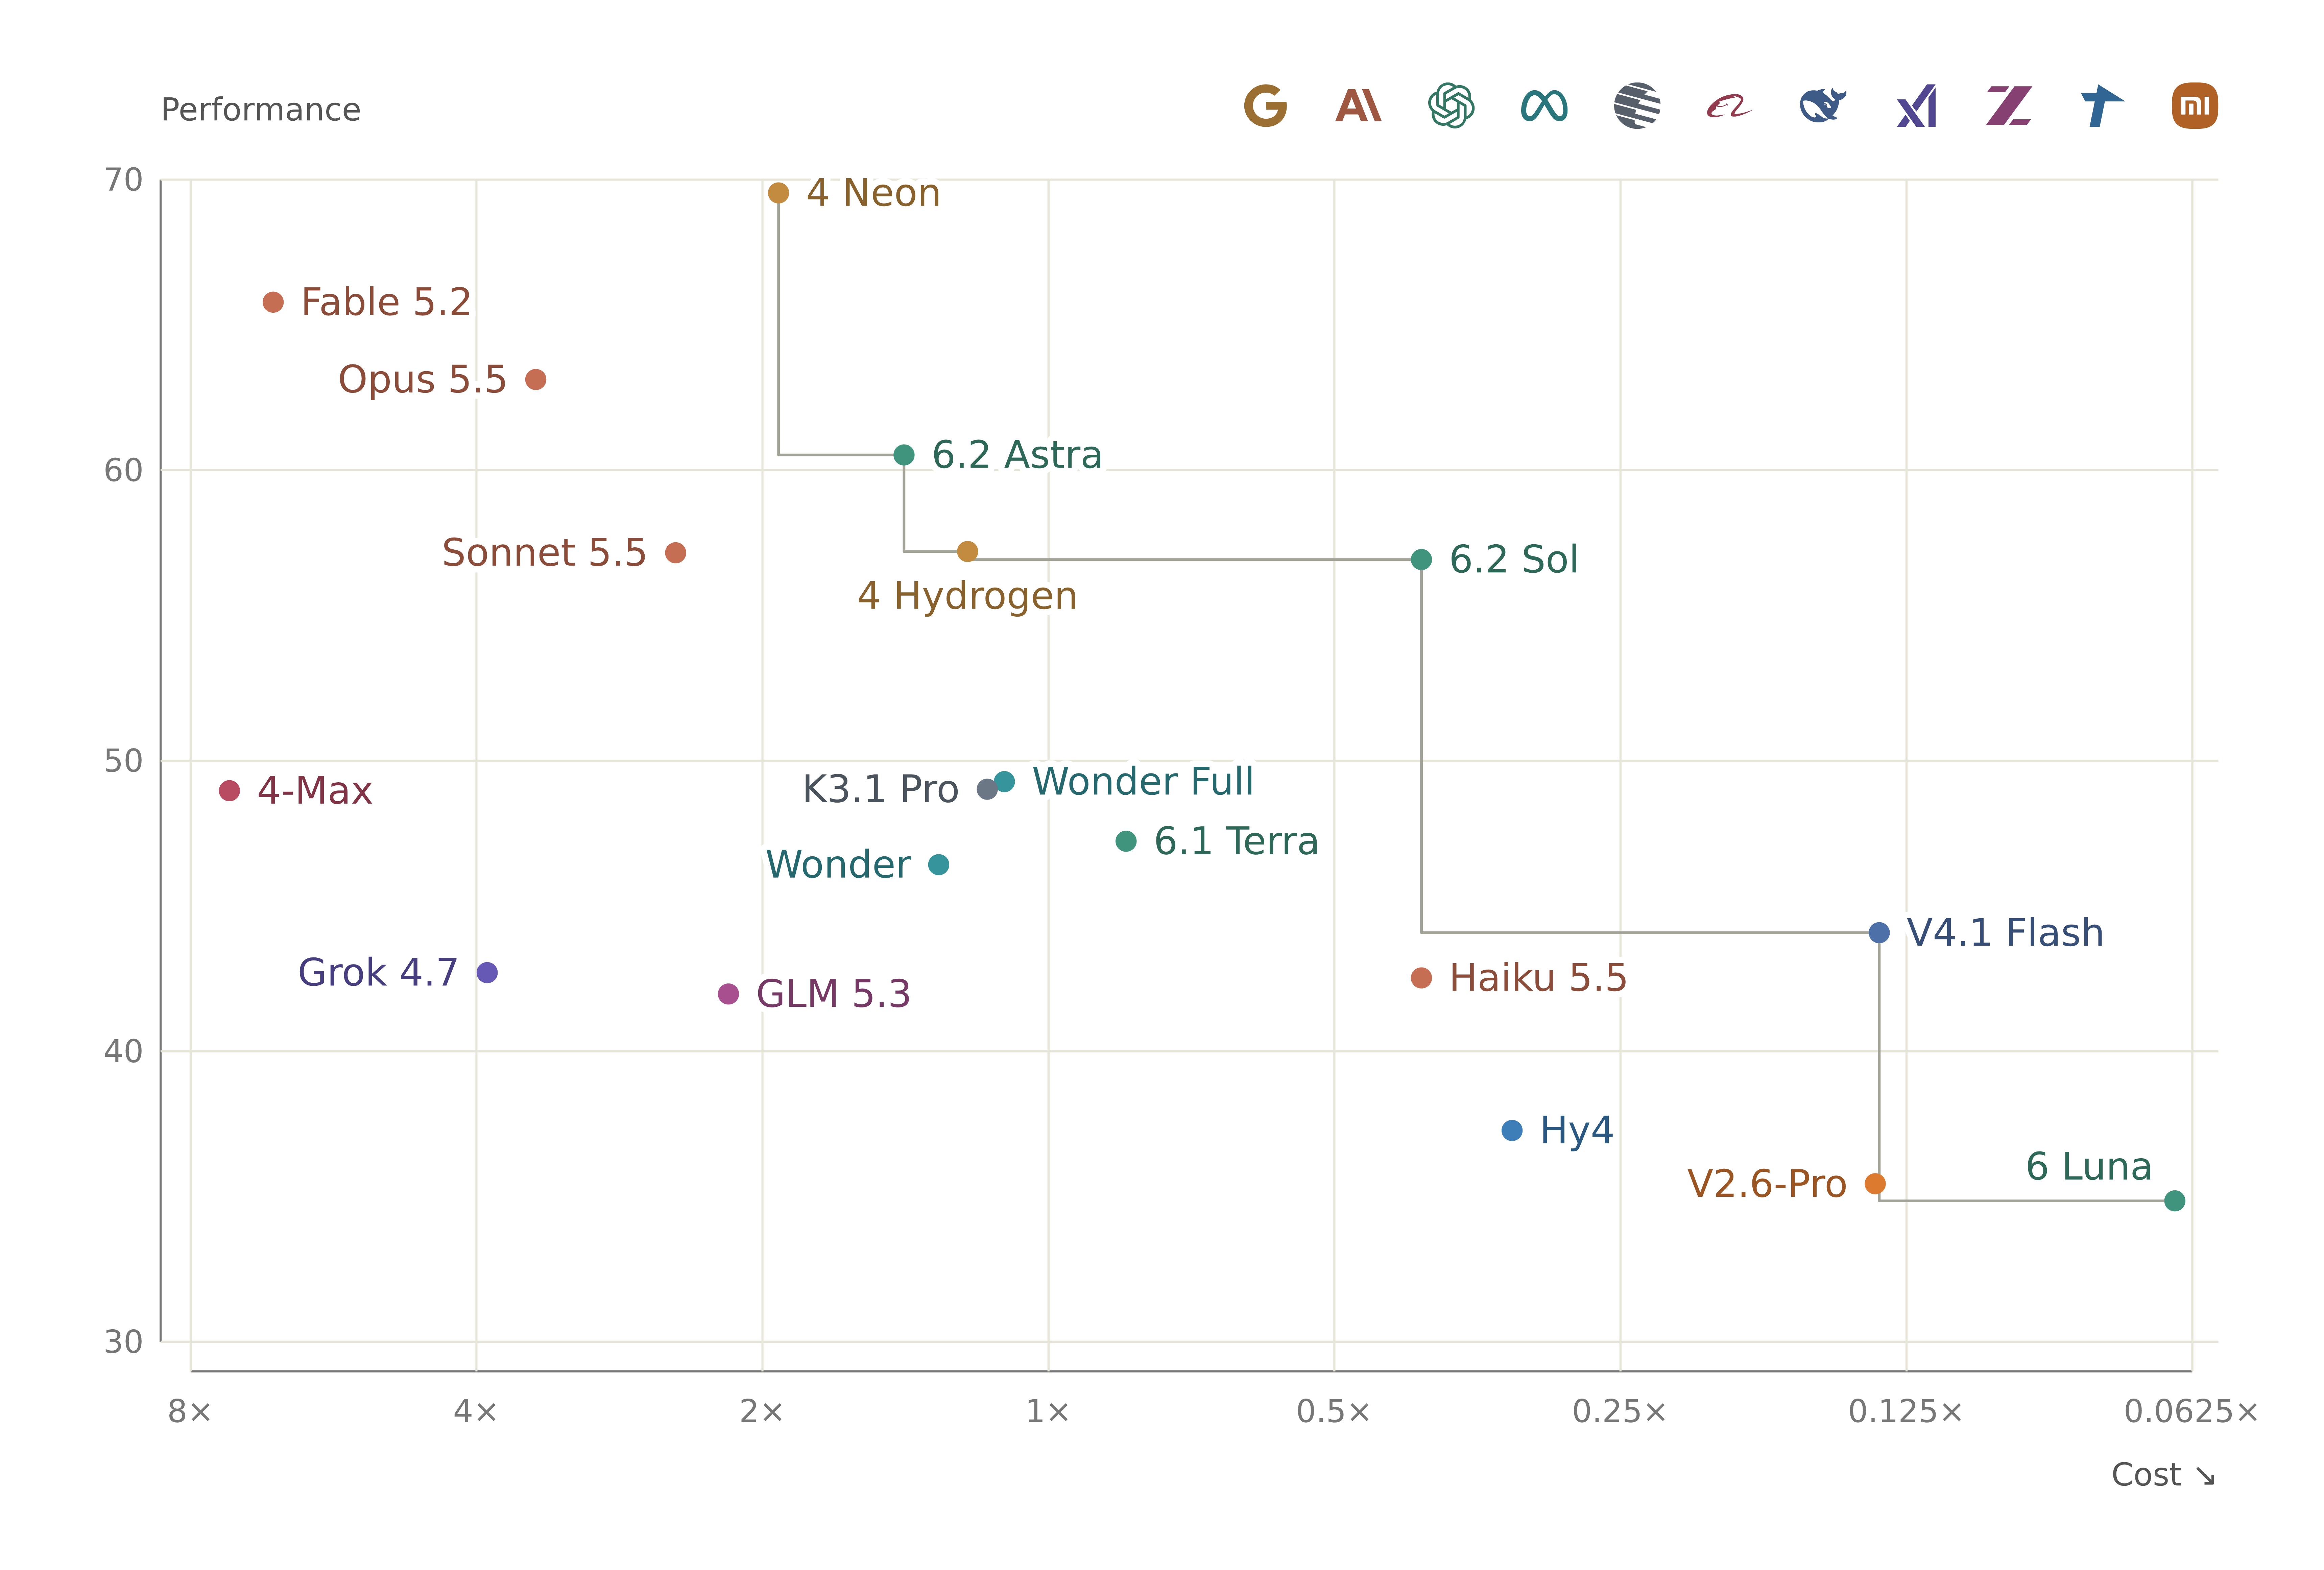
Mei:汇总十项编码基准的模型工程表现指数
Mei 对十项编码基准的成绩、成本和词元用量作相对化处理;页面同时披露证据覆盖不均、缺少误差条及结果未经独立验证等限制。
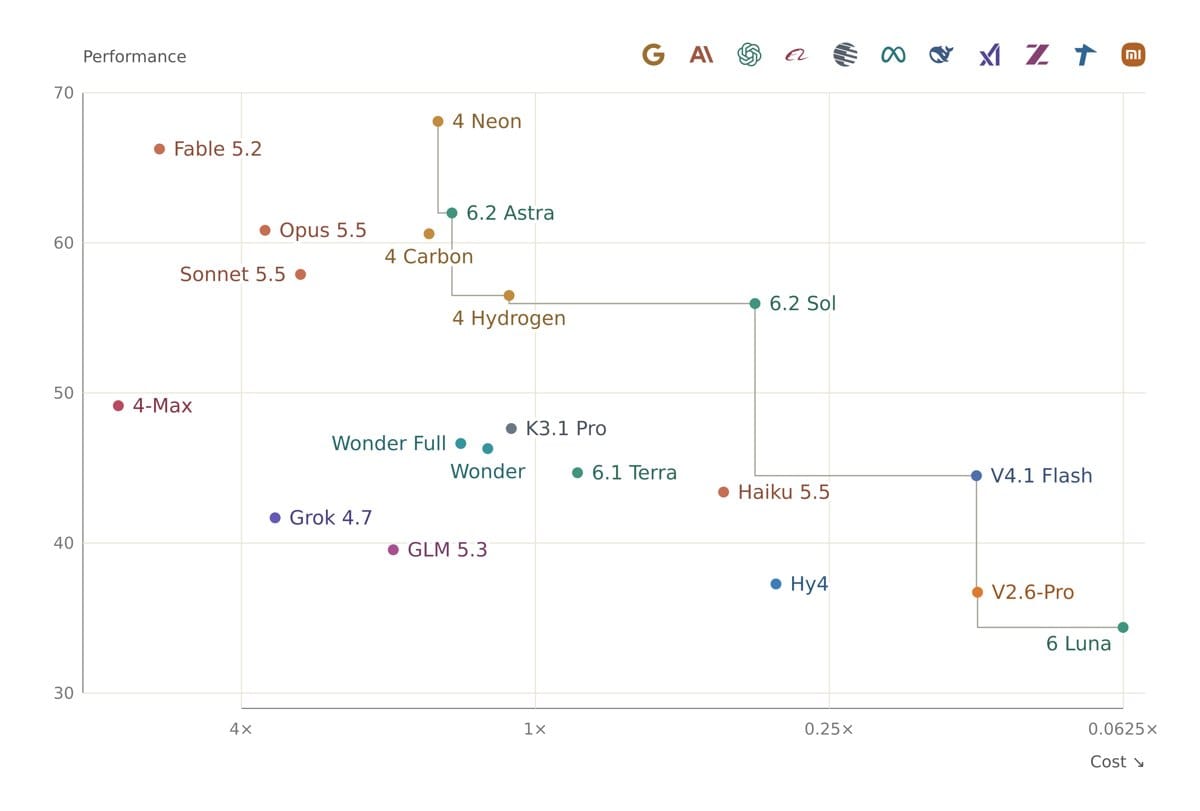
资讯整理 · git-aarvin.github.io · 原文日期 2026-11-19
十项基准如何合成指数
Mei 将语言模型在十项编码基准上的成绩汇成工程表现指数。按页面说明,计算会针对基准难度和缺失结果作调整,使所列模型的平均分为50。成本和词元用量也采用同类调整,以典型模型为1倍参照。阅读这些数值时,需要保留其相对指标的含义。
成本栏对应基准运行费用
成本栏采用各项基准报告的运行费用,反映的是运行时的价格以及该基准的具体设置。页面明确提醒,这并不代表模型处理用户自身工作负载的成本。因此,表中的成本倍数需要连同评测条件理解,不能直接当作实际项目的预算估计。
分差受覆盖范围与权重影响
页面承认,不同模型接受测试的基准子集不同,部分分数所依赖的证据明显更少;由于没有误差条,小幅差距没有明确意义。各基准无论规模和可靠性如何都获相同权重。此外,分数取决于所列模型,新增或移除模型也会使分数变化。
汇总结果未经独立验证
Mei 采用已发表的结果,页面说明这些结果未经独立验证,也可能受到数据污染或针对基准调优的影响。因此,这份指数提供的是对既有评测结果的汇总,不能视为独立复测所得的结论;页面也明确将基准定位为真实工程工作的替代指标。
原始标题:Mei—or, the Models Engineering Index—calculates language models' practical performance on engineering tasks. Mei calculates language models' engineering performance.
来源:git-aarvin.github.io