MMFlash:结合视觉依赖、目标置信度与草稿误差调整训练
MMFlash通过有无图像时的预测差异衡量视觉依赖,并结合目标模型置信度和草稿预测误差调整训练权重;长视频另用稀疏注意力,评估范围限于图像或视频输入、文本输出。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-13
用两次预测衡量视觉依赖
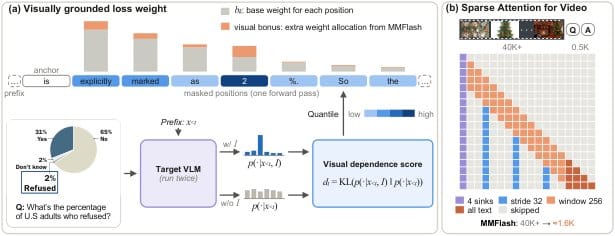
MMFlash研究视觉语言模型的推测解码,由轻量草稿模型提出词元,目标模型并行验证。作者用“视觉依赖度”定位训练重点:固定文本提示与已生成前缀,分别保留、移除图像运行目标模型,再计算两次下一词元分布的KL散度。
目标置信度约束视觉加权
作者先将视觉依赖度映射为训练语料中的分位数,再乘以目标模型含图像预测分布的置信度因子exp(-H),其中H为分布熵。因此,视觉依赖强并不必然带来较大加权;目标模型自身越不确定,这部分训练信号就越受抑制。
在上述条件下,额外权重还随草稿模型当前预测出错的概率变化。论文保留DFlash的交叉熵目标,让尚未学好的相关词元获得更多训练关注;随着草稿预测改善,额外加权逐渐退回基础权重。
长视频保留哪些注意力位置
针对长视频,作者给草稿模型采用稀疏注意力,保留少量注意力汇聚位置、按间隔抽取的视觉词元、全部文本词元及局部窗口,训练与推理使用相同模式。其依据是作者观察到草稿注意力偏向邻近位置,视觉词元之间存在较多冗余。
在线训练用计算换存储
训练草稿模型需要读取目标模型的隐藏状态。论文说明,预存这些状态的空间随训练词元数和读取层数增长,在其数据上通常达到数十TB。因此作者采用在线训练,逐批运行目标模型并传递隐藏状态,代价是每一步都要承担相应计算与传输成本。
文本输出范围与视频限制
论文的设计和评估范围是接收图像或视频、生成文本的视觉语言模型。作者明确指出,视频方案依赖简单稀疏注意力和轻量微调,尚未采用专门面向视频的草稿模型;长视频起草仍比图像更困难,现有结果不能直接延伸到音频输入或语音生成。
原始标题:MMFlash: Faster Speculative Decoding for Vision-Language Models
来源:arxiv.org


