Muir:按擦除与写入敏感度分配线性注意力参数
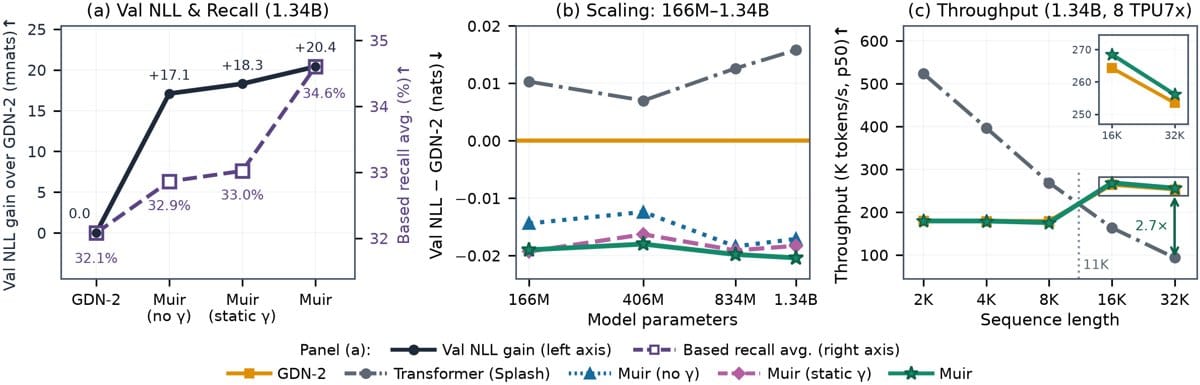
Muir 将门控参数分配、状态读出和分块训练放在一起设计:压缩擦除门,把省下的参数用于前馈网络,并调整不同状态行对输出的贡献。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-05
擦除与写入采用不同参数容量
线性注意力把上下文压进固定大小的键值状态。Muir 作者分析认为,状态更新对擦除的敏感度低于写入:键经过激活和单位归一化后,能量集中在少量通道,而值写入会缩放所有通道。因此,擦除门可以采用更低秩的参数化,无需与写入门对称配置。
把节省的门控参数交给前馈网络
据此,Muir 将递归门和输出门融合进按敏感度分配容量的低秩投影,并在固定参数预算下拓宽前馈网络。这里的设计包含两项联动调整:压缩门控投影,以及增加前馈网络容量。作者将后者用于增强事实关联的容量,并未把省下的参数直接移除。
用读出加权平衡状态行
另一个问题出现在读取状态时。作者指出,衰减慢的状态行会积累更大的范数,在不加权的读出中占主导,迫使模型在写入时加强擦除以压制干扰。Muir 为此引入匹配滤波读出门,重新分配各行贡献;作者希望借此减少写入时的擦除,而不是提前覆盖已存关联。
大分块训练避开衰减除法
训练实现也随之调整。为在宽矩阵单元所需的大分块下保持稳定,作者设计了以边界为枢轴的分块内核:拆分相对衰减计算,避开除法和整块三维衰减张量,再用分块矩阵乘法求解块内三角系统。这项设计针对大分块训练中的数值稳定与硬件利用问题。
原始标题:Muir: Linear Attention with Sensitivity-Allocated Gating and Matched-Filter Readout
来源:arxiv.org


