Piccolo:用语义切片和实验记忆迭代决策模型
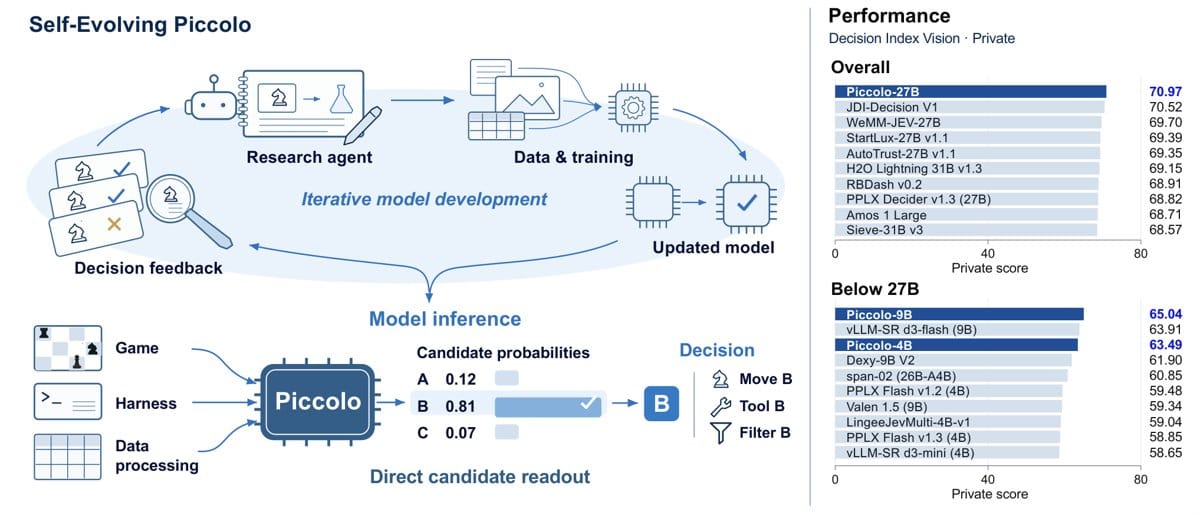
Piccolo为文本和图像判断返回候选答案概率,并让研究智能体依据数据切片与历史实验调整训练。论文同时记录了损失下降却答对更少的现象,以及实验分支的归因限制。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-18
直接读取候选答案概率
Piccolo面向文本和图像判断,从语言模型输出头直接读取候选标签的分数,返回候选答案的概率分布。论文介绍的接口支持备选项选择、有序等级评分和是非判断;调用方可据此选择动作、设置置信度阈值,或将决策升级处理。
用语义切片追溯数据问题
训练数据按领域、能力、任务功能、难度和学习价值标注,组成语义切片,让研究智能体一起分析同类样本的训练动态与决策准确率。每条样本保留身份和来源,便于把切片层面的发现追溯到具体数据,再进行检查、修订或定向合成。
把诊断写入共享研究记忆
迭代反馈按语义切片汇总学习动态、推理结果和数据统计,诊断再把进步或退步关联到切片与测试设置。相关资产和发现进入共享研究记忆,供后续提案复用;下一轮也可从保留的历史模型出发。研究者可以介入,提出方向并设置优先级和预算。
损失下降与答对数量分开观察
在同一组固定的数据处理与智能体工作流硬标签题上,作者比较目标与预测分布的KL散度,以及答对题数的净变化。后期前者继续下降,后者却转为负值。作者据此强调,仅凭训练损失分配数据可能遗漏问题,并报告随后下调了该类数据的混合权重。
确认迁移与实验归因的边界
数据分配研究将反复调优的问题与不重叠的确认题分开,后者用于检查效果能否迁移到其他问题。论文也说明,部分分支虽然样本暴露预算相近,起始参数和多项数据分配却同时不同,因此结果描述的是完整研究路径,不能据此孤立判断某项调整的作用。
原始标题:Piccolo: Co-Evolving Decision Models and Data through Recursive Self-Improvement
来源:arxiv.org


