RLVR 权重混合讨论:复算依据、保存精度与覆盖疑问
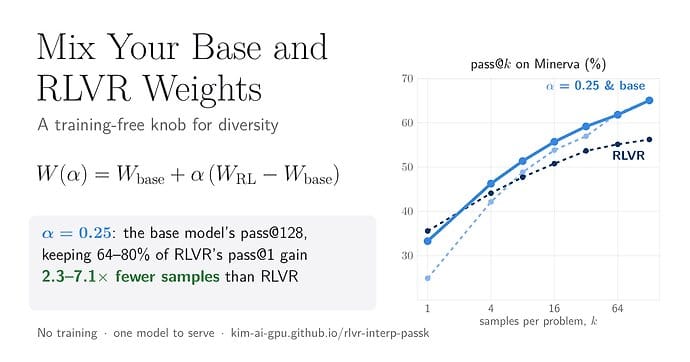
作者提出无需训练的权重插值方法;回复者报告评分复算与舍入检查,并追问汇总覆盖相近是否意味着恢复了同一批题。
社区观察 · Hugging Face · 原文日期 2026-11-19
插值方法只测试了一组模型
umjunsik1323 提出,在基础模型与其 RLVR 版本之间做线性权重插值,以 α 调节更新占比,无需额外训练,混合后部署一个模型。测试采用 Qwen2.5-7B 与对应的 SimpleRL-Zoo 版本。作者明确承认,证据仅涉及一对 7B 模型的数学任务,没有哪个 α 能同时胜过两端模型。
复算依据是作者公开的样本
nootxlm 表示,自己用独立代码,对作者公开的逐样本结果采用合并无偏估计进行复算,并列出 Minerva 与 OlympiadBench 的计算结果。这份回复提供的是参与者对既有样本的重新计算,没有声称重新生成测试答案。因此,阅读其支持意见时,需要保留复算所依据的数据范围。
保存后检查更新是否归零
对于保存精度,nootxlm 称其抽查了三个注意力张量,支持作者对这组权重采用 fp16 或 fp32 的建议,认为 bf16 舍入会抹去大部分混合更新。他还建议发布前逐个对照保存张量与基础权重,统计预期更新变为零的比例。这项抽查报告的范围仍是三个张量。
总覆盖相近是否恢复了同一批题
与 nootxlm 关注汇总复算不同,SheilaMayoAI 追问:覆盖总量相近,是否可能来自新解出的题抵消旧损失?该用户建议逐题配对比较基础、RL 与混合模型,并强调有限采样只能显示带有不确定性的变化。同时,其明确声明尚未复算评分或检查个别样本;所给讨论中也没有这一重合情况的答案。
原始标题:Mixing a base model with its RLVR model gets back the diversity RL takes away (training-free)
来源:Hugging Face


