ScaleVLA:用冻结的视觉语言骨干学习机器人动作
研究将预训练多模态特征直接交给动作网络,在扰动环境中报告更高成功率;少样本实验仍使用完整训练集的归一化统计,异步执行也存在反馈延迟。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-16
骨干提供特征,动作网络学习控制
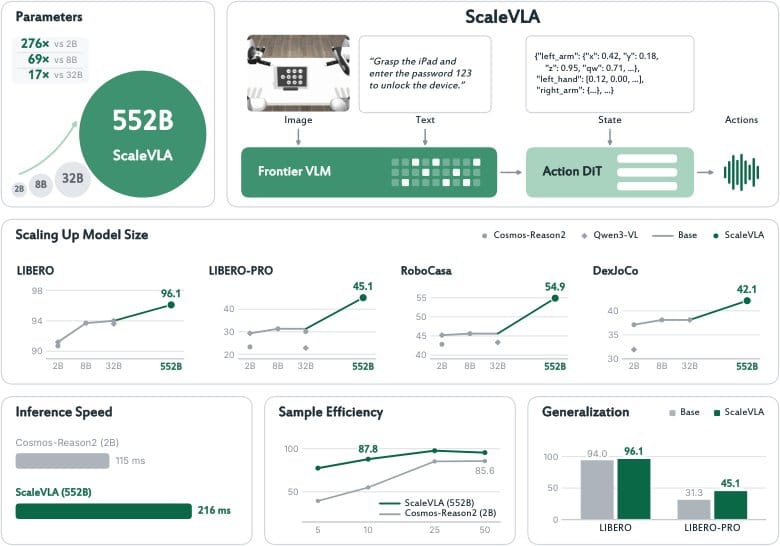
ScaleVLA将视觉语言骨干与动作网络连接:前者编码相机图像和语言指令,后者结合机器人状态生成连续动作块。视觉与语言骨干保持冻结,动作侧组件接受训练。模型不生成文字推理,每个动作块只读取一次骨干特征,再将其直接映射为动作。
扰动评测报告迁移收益
作者将完整示范数据训练的LIBERO策略直接用于LIBERO-PRO,不重新训练。评测每种设置运行500回合,以三种设置成功率的等权平均计分:ScaleVLA为45.1%,较小骨干最高为31.3%。不过,各策略受扰动后均明显退步,ScaleVLA在物体套件的环境扰动中也未领先。
少样本计数不涵盖全部预处理数据
少样本实验中的示范数量有明确边界:策略更新使用选定的轨迹子集,但状态与动作的归一化仍采用完整训练集统计量。因此,文中的示范数量描述的是策略更新用量,不能解释为训练与预处理使用的全部数据。阅读其数据效率结果时,需要保留这一条件。
异步执行需要检查观测是否过时
在DexJoCo中,控制器可在策略生成下一个动作块时继续执行缓存命令。但这些命令可能依据较早的观测,控制器频率无法单独说明策略响应新反馈的速度。论文因此提出,应同时报告动作块延迟、命令执行时的观测年龄,以及缓存没有有效命令的时间区间。
原始标题:ScaleVLA: Scaling Vision-Language-Action Models to 552 Billion Parameters
来源:arxiv.org


