SLA:在持续预训练中给机器人视觉表示加入空间监督
SLA将三维表示对齐贯穿持续预训练与下游适配,辅助模块仅用于训练;真实机器人任务中仍存在部分完成却无法完整执行的情况。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-05
把空间对齐贯穿两个训练阶段
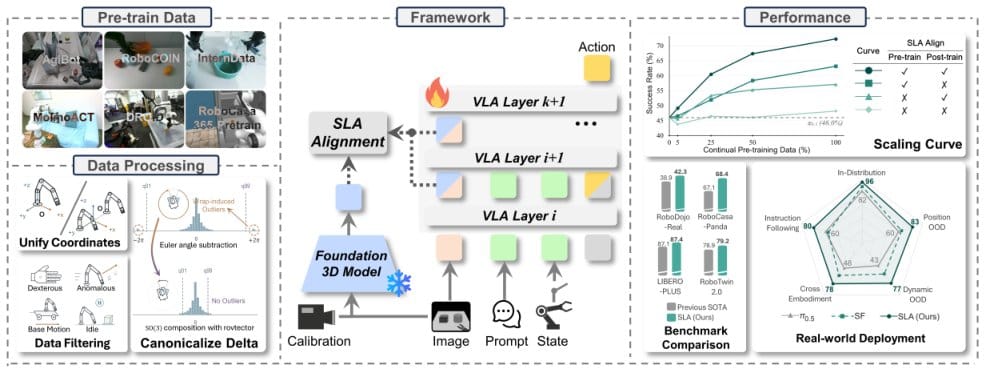
SLA从已有的π0.5机器人策略出发,同时训练动作预测与空间表示对齐:让模型中间层的视觉表示学习冻结三维感知模型提供的空间信息。作者将这种监督用于持续预训练,并保留到下游后训练,希望空间能力能跨任务迁移。
用门控适应不同机器人数据
面对不同机器人、任务与场景,SLA通过依赖输入特征的门控,聚合多个层的视觉表示接受空间监督。教师模型还能利用部分样本已有的深度和相机标定,这些信息并非所有样本的必需输入;训练时另以概率丢弃状态输入,促使策略依赖视觉线索。
部署时移除空间监督模块
空间监督的辅助组件只参与训练。部署时,策略不再运行外部三维感知教师、对齐投影器和层选择门控,保留原有推理架构。因此,这套方法把三维模型用于塑造策略内部表示,无需在每次动作预测时额外调用它。
用历史画面补充短期记忆
论文还记录了一种画面记忆机制:保留回合初始帧,再加入此前八秒中每秒一帧的主相机画面,按时间先后排列。回合开始不足八秒时,以初始帧补齐缺失位置。腕部相机只提供当前帧,历史画面仅取自主相机。
真实任务仍有完整执行失败
作者在RoboDojo-Real上,将三种机器人形态的18项任务联合后训练为单一策略。该评测的得分记录部分进展,成功率只计完整执行。Piper X上的盖笔帽与挂杯任务虽分别得到18.0和8.0分,完整成功率仍为零,说明局部动作进展不能等同于任务完成。
原始标题:SLA: Scaling Spatial-Language-Action Model via Continual Pre-training
来源:arxiv.org


