TTB:把跨视角注意力输出写入轻量网络,加快新视角渲染
TTB 用快速更新的多层感知机保存场景信息,并通过成对上下文输入对齐重建与渲染。论文报告了渲染提速,同时也显示重建阶段的额外开销。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-12
把学习目标改为注意力输出
TTB 面向新视角合成,核心是调整测试时训练中快速更新的多层感知机(MLP)的学习目标:从拟合原始值词元,改为拟合跨视角注意力的输出。作者希望由注意力提取场景信息,再将其写入轻量网络,供后续视角渲染使用。
用成对输入对齐重建与渲染
重建阶段能看到图像与相机信息,新视角渲染时却只有相机输入。为处理这种差异,TTB 将每个上下文视角拆成两路:一路保留图像和相机信息,提供学习目标;另一路只含相机信息,作为 MLP 输入,并与后续新视角共享更新后的网络。
渲染帧率与重建开销分开看
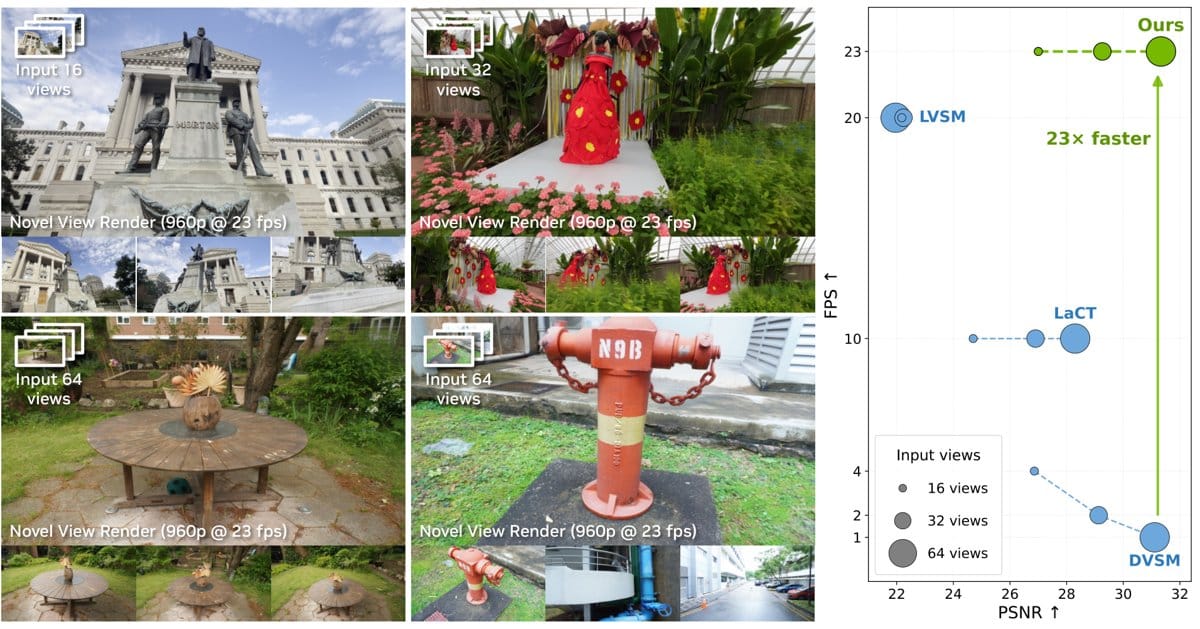
作者在 DL3DV、544×960 分辨率、32 个输入视角下报告:不使用批处理时,TTB 每秒渲染 23 帧,DVSM 的 ps8 版本为 2 帧;单场景重建耗时则分别为 18 秒和 15 秒。这里帧率衡量渲染速度,重建时间另计,因此帧率差不能直接代表完整任务的耗时收益。
固定场景状态不等于峰值显存
在论文的 544×960 分辨率分析中,TTB 重建后保留的是固定大小的快速权重矩阵。作者报告,所有网络块的这部分状态在 FP32 精度下共占 324 MB,不随上下文视角数增长。这个数字描述场景表示,不能当作整个推理过程的峰值显存。
原始标题:TTB: Test-time Baking for Efficient Rendering of Decoder-only View Synthesis Models
来源:arxiv.org


