TrnRT:面向 Trainium 的离线编译与双层前缀缓存
TrnRT 首先支持 GLM-5.3-Flash,通过融合解码内核、设备与主机缓存及离线编译组织推理服务;仓库同时说明了早期构建与当前代码的验证范围。
项目实践 · github.com · 原文日期 2026-11-17
首个支持模型与服务接口
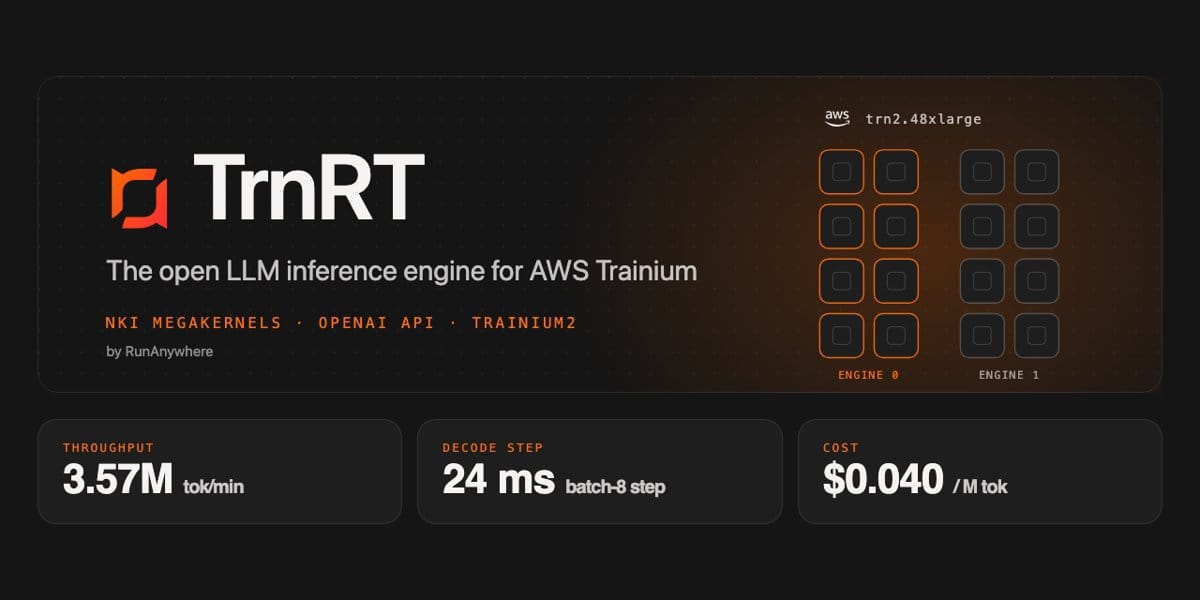
TrnRT 是面向 AWS Trainium 的开源大模型推理引擎,文档称可在一台 trn2.48xlarge 上提供兼容 OpenAI 的接口。当前首个受支持模型是 GLM-5.3-Flash;更多开放模型仍属后续计划,文档没有将它们列为已经可用。
融合解码内核与两级缓存
文档将解码组织为每半层一个融合的 NKI 内核,覆盖注意力及 MoE 等运算。前缀缓存用基数树管理 FP8 KV 页,并以主机内存保存被逐出的页和状态检查点。每台机器运行两个引擎,各跨 32 个逻辑 NeuronCore 做张量并行,路由器按会话分配请求。
先准备离线编译环境
快速入门列出的起步条件是 Docker、一台用于服务的 trn2.48xlarge,以及用于编译的 x86_64 主机。所有计算图在 CPU 主机上构建,服务机器负责加载产物,默认不执行编译。因此,部署准备包含编译环境与服务环境两部分,不能只考虑接口启动。
早期构建与当前仓库的核对
性能表使用的是早期构建。仓库报告,当前代码在默认解码批量为 12 的配置下,157 个图在全部 32 个 rank 上均通过等价检查,384 个请求的输出逐字节一致,双引擎服务也通过端到端检查。这些是项目自述的核对结果,不能直接视为当前版本性能的独立复测。
原始标题:Show HN: TrnRT – An open-source LLM inference engine for AWS Trainium
来源:github.com

