拆解多模态视觉编码:专用容量与预训练的作用
论文在共同数据与匹配训练总算力下,分别考察视觉先验、专用参数和融合位置,报告单独预训练可省略,但视觉专用容量仍有作用。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-12
把视觉编码拆成三项选择
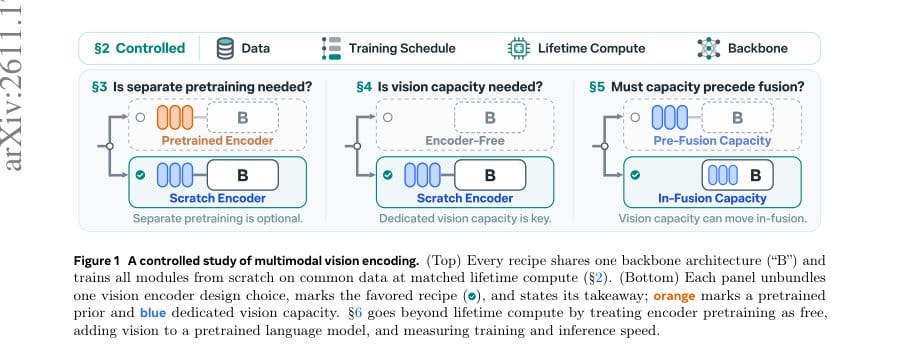
论文把视觉编码拆成三项选择:上游预训练带来的视觉先验、仅供视觉词元使用的专用参数,以及这些参数位于图文融合之前还是骨干内部。作者逐项控制变量,考察编码器的收益来自哪里;数据、架构和算力各异的已发布模型,难以直接用于隔离这些因素。
总算力包含上游训练
作者将各训练阶段的FLOPs相加,作为模型的总训练算力:既计入多模态训练,也计入此前可能进行的纯文本训练和编码器预训练,但不含指令微调。由于各方案处理每个词元的成本不同,匹配算力并不意味着训练词元数相同。这一口径对应项目在各阶段之间分配同一笔预算的情形。
视觉专用容量可以移入骨干
在共同数据、匹配总训练算力下,各检查点用448×448图像在Cambrian-7M上指令微调三轮;VQA均分先取16项基准的一般、知识、文字与图表、视觉中心四类均值,再平均。作者报告:从零联合训练编码器与单独预训练表现相当;无编码器方案即使按编码器参数量扩充骨干仍落后;将视觉专用模块放入骨干最早几层,则与前置编码器表现相近。
共同数据仍有阶段差异
理解实验还需区分各阶段的数据形式。编码器预训练使用MetaCLIP英文图文对的原始替代文本,多模态训练则统一使用Qwen2.5-VL-32B重新生成的描述,并按70∶30混合纯文本与图文序列。因此,带预训练编码器的方案会将更多总训练算力用于图文数据;共同来源并不表示各阶段输入完全一致。
原始标题:Unbundling Multimodal Vision Encoding
来源:arxiv.org

