VFlash:按完整空间图元并行生成视觉计划
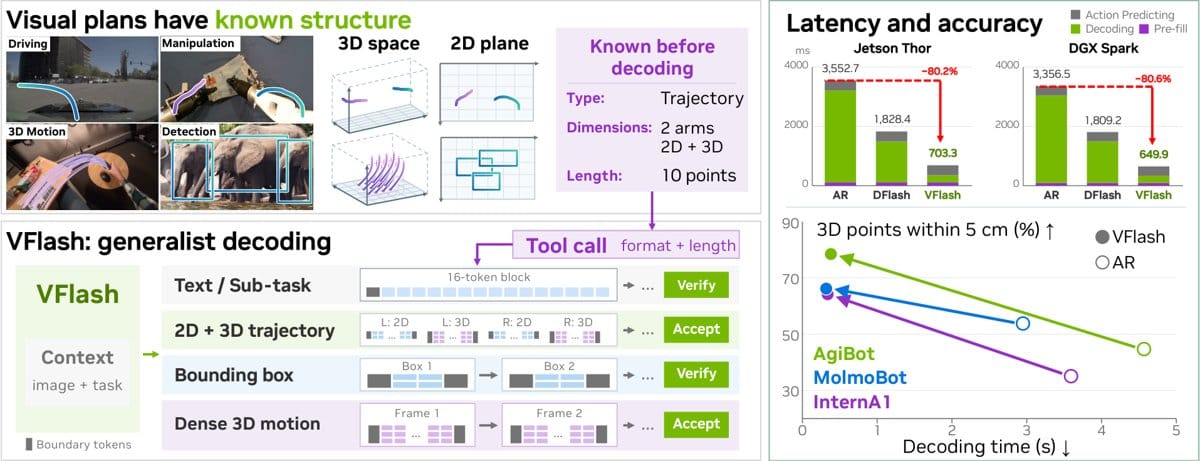
VFlash 利用边界框、轨迹等输出的已知结构,一次预测整组坐标。它用标注数据训练草稿模型,并将空间输出的接收条件与文本验证分开处理。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-05
让预测块覆盖完整图元
视觉计划可以用点、边界框和轨迹表达空间目标。VFlash 的做法是先确定图元类型、坐标维度和长度,再让轻量草稿模型一次前向计算预测整个图元。可变长度预测由工具调用声明长度,固定大小的边界框则由类型确定布局;同一条轨迹的二维与三维坐标也能联合预测。
草稿模型学习标注坐标
训练先让自回归视觉语言模型适应空间输出格式,再冻结它,以其特征训练浅层、非因果草稿模型。草稿模型的标签来自标注坐标或转换后的网格,而非目标模型续写的词元。这个设计把训练目标放在空间预测上,因此接收视觉输出时不再要求逐词元复现目标模型。
边界框增加置信度回退
框生成有两种接收方式:直接模式接受所有符合结构的框;回退模式另加空间置信度检查。后者检查各坐标候选的概率与分散程度,触发条件后用受约束的目标模型自回归重生成。因此,结构合规只是接收条件的一部分,不能单凭格式合法判断框的位置准确。
三维轨迹评估侧重路径几何
理解三维轨迹实验时,需要保留参考数据的含义:每个夹爪的路径按三维弧长均匀重采样为十个点,名义窗口为五秒,也可能在动作或回合边界提前结束。作者明确说明,这些点描述路径几何,并非固定时间间隔的控制采样,因此不能将路径预测结果直接解读为定时控制能力。
原始标题:VFlash: Fast, Accurate Visual Planning via Flash Primitive Decoding
来源:arxiv.org


