Video-Coder:先写三维场景代码,再生成视频
论文提出训练编程智能体,用可执行的三维场景提供视频结构与运动信号;训练参考视频也由模型合成,数据筛选排除了难以用几何与关键帧表达的内容。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-06
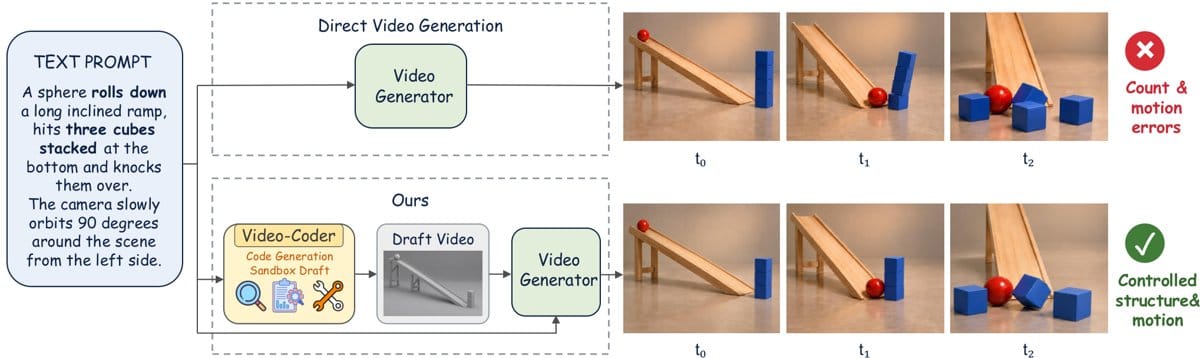
用三维草稿约束结构与运动
Video-Coder 把视频生成拆成两个环节:智能体根据文字要求编写并执行代码,构建动态三维场景,渲染成草稿视频;下游视频生成器再据此生成最终画面。作者希望通过这个中间表示,明确传递物体布局和运动信息。
提交后还要独立重跑代码
在执行环境中,提交脚本不等于通过验收。环境会在干净目录里从头重跑最终脚本,只有再次通过全部检查,才接受该轮结果并导出白模视频。这一设计把验收落在重新执行后的结果上,用来检查产物能否仅凭代码复现。
参考视频来自模型合成
训练所用的参考视频并非实拍记录。论文先用草稿视频确定几何结构、空间布局和运动,再把草稿与文字提示一起交给 MiniMax-H3 合成视频。按作者描述,结构与运动跟随白模,外观跟随提示词;这些合成结果被作为训练参考。
两阶段训练只更新编程模型
作者以 Qwen3.5-9B 初始化智能体,先用六千条样本做监督微调,学习场景规划、工具调用和根据反馈改代码,再用两千条提示与参考视频配对数据做强化学习。训练期间,视频生成器保持固定,优化对象是负责生成场景代码的模型。
数据筛选限定了覆盖范围
这套方法的数据构建有明确取舍:提示词会被改写为物体、数量、空间布局、运动过程和相机行为的描述;主要依赖精细外观、人物面部表情,或难以用三维场景编程表达的内容则被剔除。因此,材料没有提供这些内容上的能力证据。
原始标题:Video-Coder: Reinforcing Agentic Coding for Video Generation
来源:arxiv.org


