V-JEPA-LM:用反事实监督读取视频动态
作者用倒放、镜像和变速等操作生成答案确定的视频问答,尝试让语言模型使用编码器已有的动态信息;研究范围集中在短片段。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-13
编码器知道,回答却未必使用
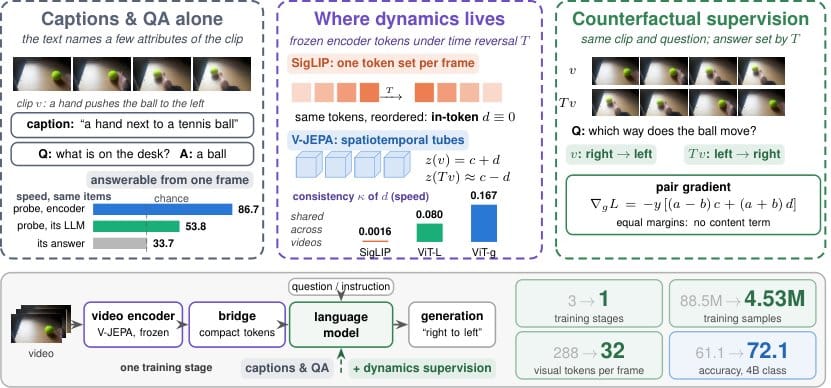
V-JEPA-LM研究视频特征与语言回答之间的脱节。作者认为,预测式视频编码器已能表示方向、速度、顺序和状态,但字幕或问答只涉及片段的少数属性,模型可能只提取文本点出的内容。因此,研究重点是改变监督信号,让语言模型使用编码器已有的动态信息。
用视频变换确定答案
生成器从公开数据集取出视频,通过倒放、镜像、变速等变换生成问题、选项和答案,覆盖方向、事件顺序、时间位置、速度、计数及中止或不可能事件。答案由变换规则确定,不需要新增人工标注或调用语言模型;涉及动作和事件的构造仍复用原数据集标签。
答案平衡与显式配对的区别
同一场景的变体在期望上均等对应各类答案,目的是使共同的场景内容难以成为答题捷径。训练样本独立抽取,不强制将同一片段、答案不同的版本放进同一批次。速度类数据没有显式配对,而是依靠答案平衡,因此不能将成对入批理解为这套方法的必要条件。
短片段之外仍有边界
论文评测针对数秒到数分钟的视频,不能据此推断小时级视频理解能力。作者指出,后者还需要记忆、跨片段检索和长上下文训练数据,并将其留待后续研究。文档、图表、文字识别和通用图像问答也不属于本研究的目标,现有结果不能直接延伸到这些用途。
原始标题:V-JEPA-LM: Video-Language Models That Read Dynamics Beyond Static, Text-Aligned Representations
来源:arxiv.org


