WeMM-Video:用时间戳对齐音视频,以偏好优化处理重复输出
报告介绍四种规模的中英双语模型,重点说明声音与画面的时间对齐、描述数据构建和重复输出治理,也指出可验证音视频推理数据的稀缺。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-19
四种规模与两种回答模式
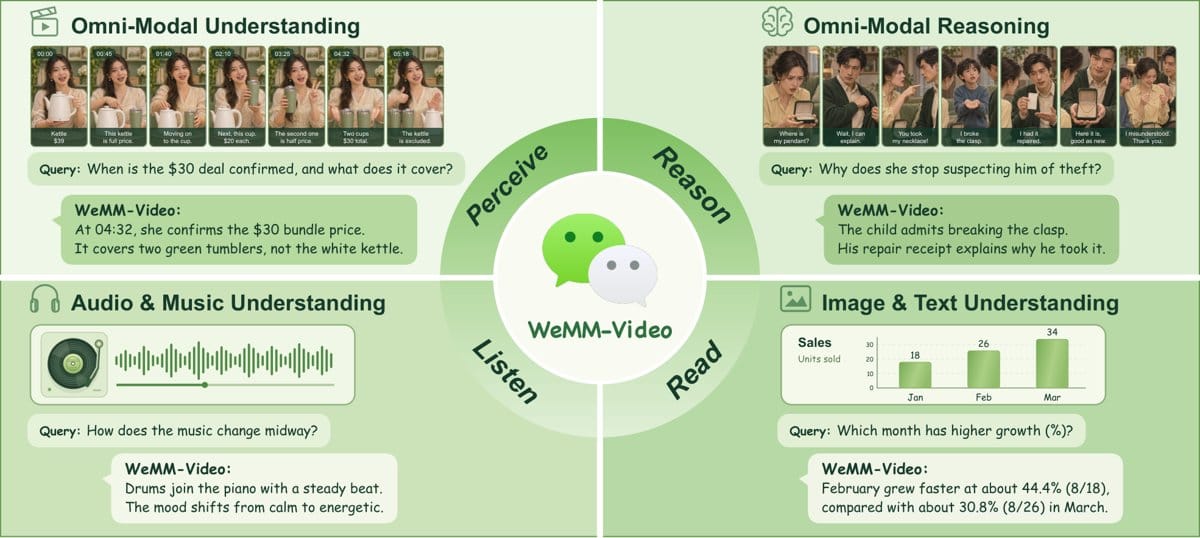
作者介绍了中英双语模型系列WeMM-Video,包含2B、4B、9B和35B-A3B四种规格,统一处理文本、图像、音频与视频。模型支持直接回答的指令模式,以及输出逐步推理的思考模式。报告称,训练使用约1.2万亿词元,并结合渐进式预训练与多阶段后训练。
每秒十个音频词元的时间对齐
声音输入按每秒16000次采样,并切成30秒片段交给音频编码器。随后,窗口级Q-Former把每个0.1秒窗口压缩成一个音频词元,即每秒十个。处理带声音的视频时,系统按时间顺序交错排列视觉与音频词元,再加入文字时间戳,用于建立声音和画面的时间对应。
用连续描述覆盖动作、对白与环境声
描述生成占训练任务词元的37.7%。其中,细粒度视觉描述选取体育、游戏、舞蹈等动作密集的视频,记录快速动作和细微状态变化;联合音视频描述则覆盖电影、访谈、直播带货等素材,把视觉动作、对白与环境声写入连续时间线。候选数据还经过自动质量评分、语义去重和有害内容过滤。
推理数据稀缺时的混合训练
作者指出,自然场景中可验证的音视频推理数据较少。为补足这部分监督,团队将带有推理过程的视觉语言科学、技术与知识问答数据,与筛选出的原生音视频推理任务结合。其训练意图是把已有推理能力迁移到音视频场景,同时保留骨干模型的问题求解能力。
离线挖掘重复输出样本
报告记录了一项训练问题:模型经过预训练和在策略蒸馏后,仍可能重复输出、持续解码,妨碍后续强化学习。团队因此从视频、音频和视觉语言任务中离线挖掘重复解码的困难负样本,再进行多轮直接偏好优化。每轮只更新LoRA适配器,轮次之间合并并重新初始化,以维持优化稳定性。
原始标题:WeMM-Video: Pushing the Frontiers of Open-Source Omni-Modal Video Understanding
来源:arxiv.org


