Xing 4:昇腾上的稀疏注意力、分布式训练与智能体后训练
报告介绍开源混合专家成员及昇腾训练方案,并通过TeleGym管理跨策略更新的执行轨迹。长上下文注意力研究主要依赖仿真,作者明确保留了部署开销方面的限制。
论文阅读笔记 · arxiv.org · 原文日期 2026-11-17
开源成员:在昇腾与MindSpore上训练
报告称,Xing 4已开源一个混合专家模型,完全使用昇腾NPU和MindSpore训练,原生支持长上下文。该成员每个词元仅激活部分参数,因此阅读其规模说明时,需要区分模型的总参数量与单个词元的激活参数量。
长上下文:压缩键值缓存并复用索引
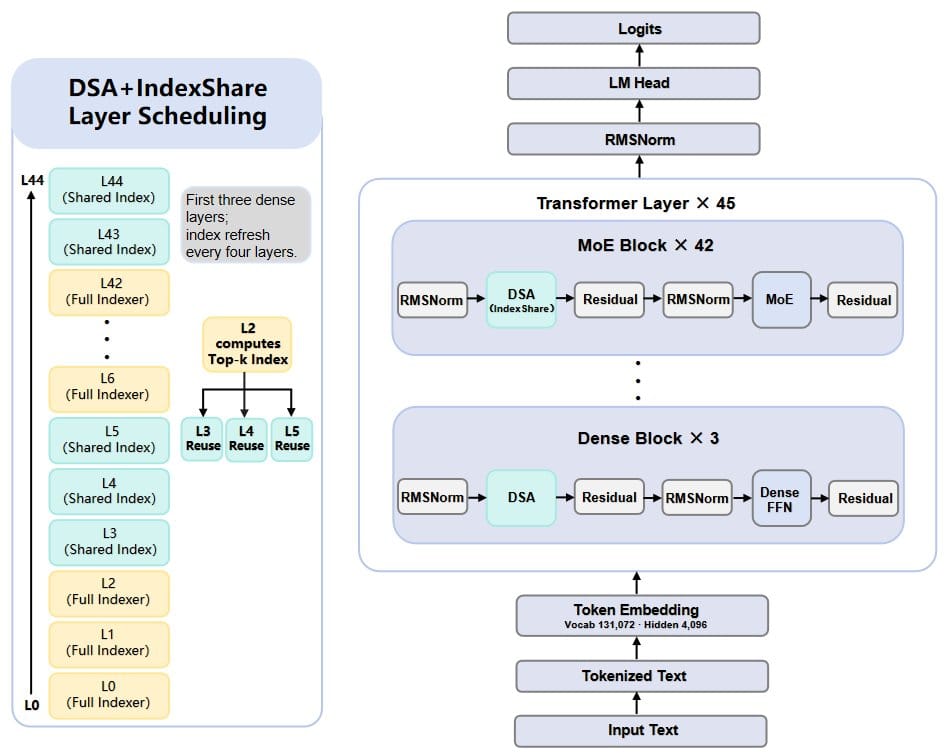
注意力设计由MLA压缩键值表示,DSA为查询选择部分历史键值,IndexShare跨层复用稀疏索引,以减少重复计算。作者主要通过仿真比较这些方案,并说明模拟无法完整覆盖生产服务开销,结果可能比端到端部署测量更乐观。
预训练:分片、计算归属与激活内存
预训练系统按集群带宽层级分布模型状态,并将Muon优化器的完整矩阵正交化交给指定进程,避免重复计算。长序列部分结合按成本分配任务、复用词元布局和按文档压缩键值,处理负载与访存问题;选择性重计算管理激活寿命,CPU亲和性及核心隔离减少主机调度干扰。
TeleGym:让未完成轨迹跨策略更新继续执行
TeleGym通过统一轨迹表示,把不同智能体执行框架、环境和持久会话接入策略优化。生成与优化在不同设备池异步运行,有界超额采样用于适应任务时长差异;未完成轨迹可在策略更新后恢复,并保留采样时的策略记录和执行级奖励分组,供后续学习使用。
原始标题:TeleChat to Xing4: Advancing Frontier Agentic Models on Domestic Chips and Frameworks
来源:arxiv.org


