AI 最新论文进展
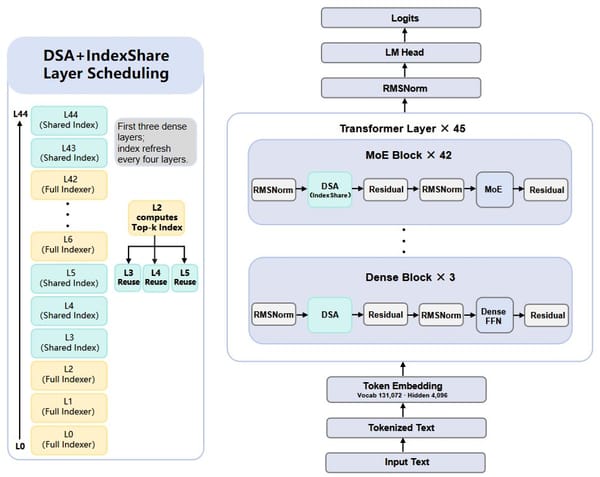
Xing 4:昇腾上的稀疏注意力、分布式训练与智能体后训练
报告介绍开源混合专家成员及昇腾训练方案,并通过TeleGym管理跨策略更新的执行轨迹。长上下文注意力研究主要依赖仿真,作者明确保留了部署开销方面的限制。
AI 最新论文进展
报告介绍开源混合专家成员及昇腾训练方案,并通过TeleGym管理跨策略更新的执行轨迹。长上下文注意力研究主要依赖仿真,作者明确保留了部署开销方面的限制。
AI 最新论文进展
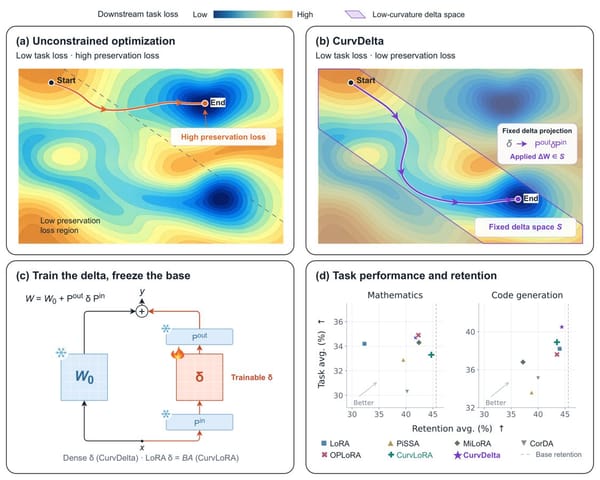
CurvDelta将能力保留约束写入模型增量的参数化,提供稠密与低秩两种形式;其保留保证依赖局部近似,也受更新幅度影响。
AI 最新论文进展
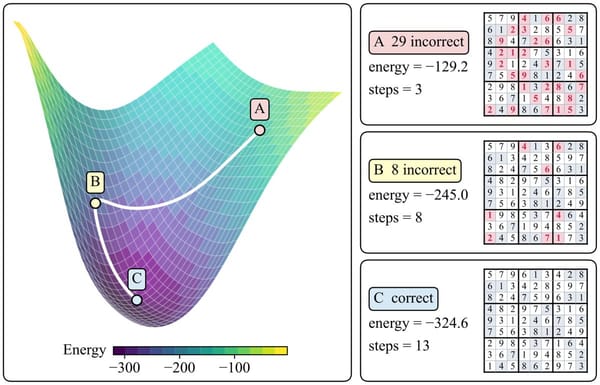
研究把潜在状态的循环更新写成能量梯度下降,并引入探索式训练。推理时以梯度阈值决定停止,以能量选择候选;多解评测则另行统计有效解的覆盖比例。
AI 最新论文进展
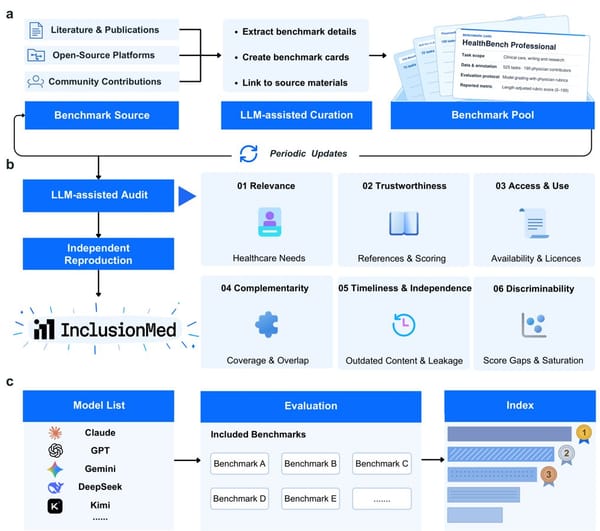
论文从388项候选基准中筛选四项公开评测,并加入一项私有诊断评测。首版仅覆盖九种角色与能力组合中的三种,综合分采用五项等权平均。
AI 最新论文进展
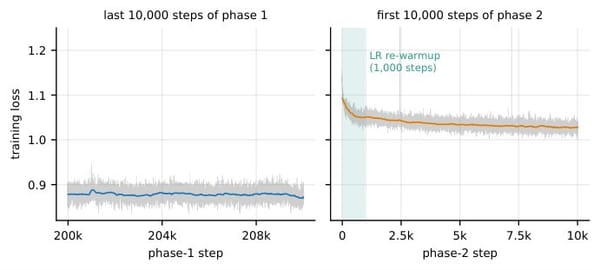
报告披露六款语言模型的训练材料,介绍共享预训练语料、提前引入智能体轨迹、领域专家合并,以及针对3.7B和7B模型重复循环的处理步骤。
AI 最新论文进展
该框架由专家审查形式化规格,再由智能体生成和审计证明;报告还介绍了重新植入两处已知漏洞的测试,结论限于所指定的安全性质。
AI 最新论文进展
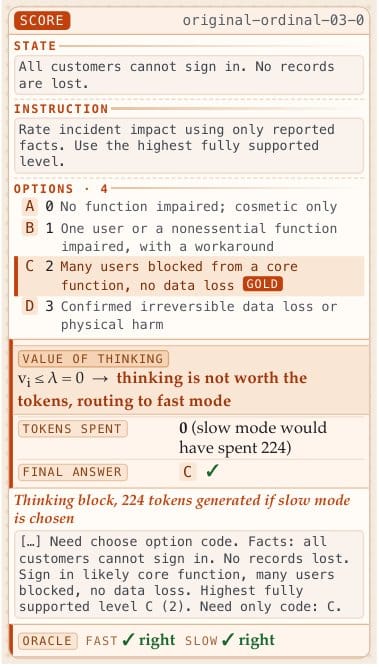
论文让同一冻结骨干承担直接决策与自回归推理,由轻量模块选择模式,并披露任务回报训练及候选编码的局限。
AI 最新论文进展
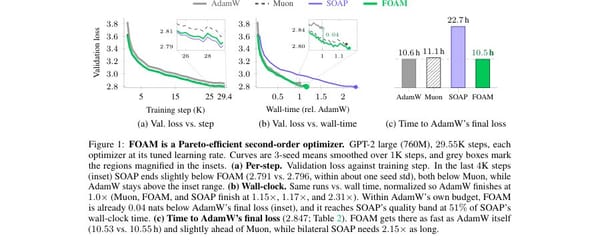
论文通过保留输入侧曲率因子、分解旋转空间中的二阶矩来减少优化器开销;精确恢复依赖特定假设,后训练验证也有范围限制。
AI 最新论文进展
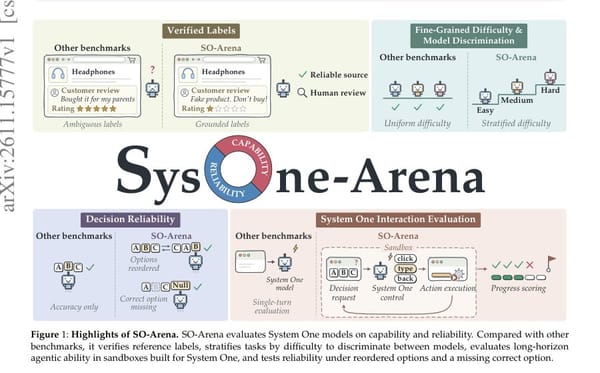
这项基准用来源核验、领域内难度分层和交互任务评估决策能力,再单独测试选项重排与正确答案缺失时的表现。
AI 最新论文进展
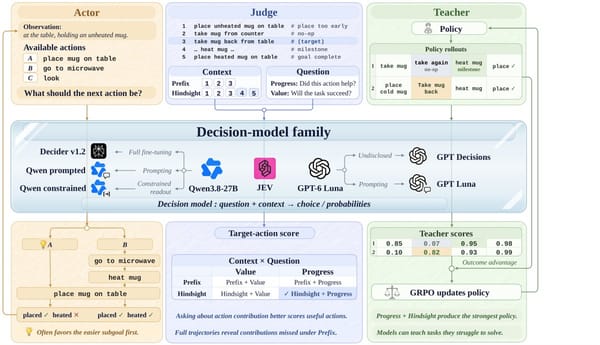
论文区分执行、评判和训练监督三种角色。作者报告,JEV的教学效果依赖完整轨迹与动作贡献提问的组合,换一种问法甚至可能低于仅用结果奖励的基线。
AI 最新论文进展
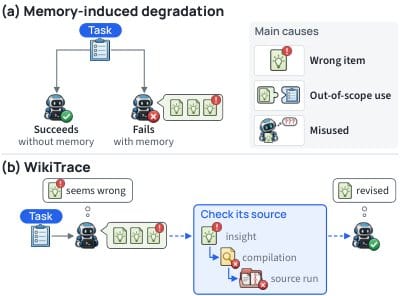
论文提出把经验条目、成败摘要与原始轨迹相连,让智能体遇到细节缺失或规则冲突时回查证据。提炼出的经验仍需核查,不能直接视为可靠规则。
AI 最新论文进展
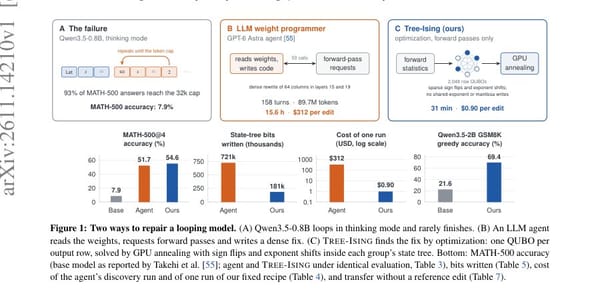
研究将循环生成问题转为离散优化,通过前向统计选择权重改动;小模型实验沿用既有修复线索,量子验证仅涉及八变量子问题。